Spark - Streaming
流处理
- Spark SQL 中的 DataFrame API 和 DataSet API 都是基于批处理模式对静态数据进行处理
- 在 2013,Spark 的流处理组件 Spark Streaming 发布,现在的 Spark Streaming 已经非常成熟,应用非常广泛
原理
- Spark Streaming 的原理与微积分的思想很类似
- 微分是无限细分,而积分是对无限细分的每一段进行求和
- 本质 - 将一个连续的问题转换成了无限个离散的问题
- 流处理的数据是一系列连续不断变化,且无边界的,永远无法预测下一秒的数据
- Spark Streaming 用时间片拆分了无限的数据流
- 然后对每个数据片用类似于批处理的方法进行处理,输出的数据也是分块的
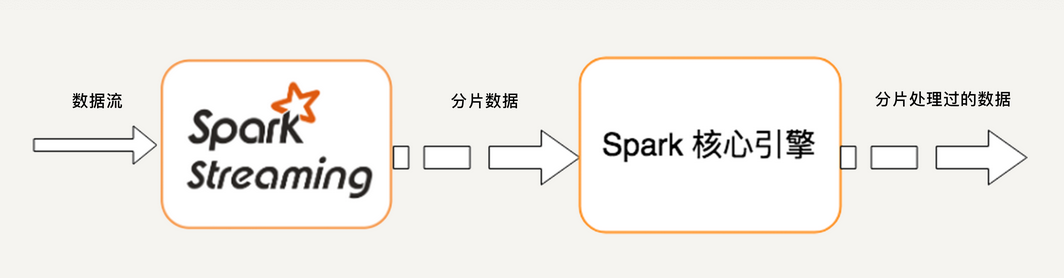
- Spark Streaming 提供一个对于流数据的抽象 DStream
- DStream 可以由 Kafka、Flume 或者 HDFS 的流数据生成,也可以由别的 DStream 经过各种转换操作得到
- 底层 DStream 由多个序列化的 RDD 构成,按时间片(如一秒)切分成的每个数据单位都是一个 RDD
- Spark 核心引擎将对 DStream 的 Transformation 操作变为针对 Spark 中对 RDD 的 Transformation 操作
- 将 RDD 经过操作变成中间结果保存在内存中
- Spark SQL 中的 DataFrame 和 DataSet 同样基于 RDD - Spark 最基础的数据抽象 - Java Primitive Type
- 无论是 DataFrame、DataSet、DStream,都具有 RDD 的不可变性、分区性和容错性等特性
- Spark 是一个高度统一的平台
- 所有的高级 API 都具有相同的性质,相互之间很容易转化
- 野心 - 用一套工具统一所有数据处理的场景
- Spark Streaming 将底层细节封装起来,对开发者来说,只需要操作 DStream 即可
DStream
一个连续的 RDD 序列,每个 RDD 代表一个时间窗口的输入数据流
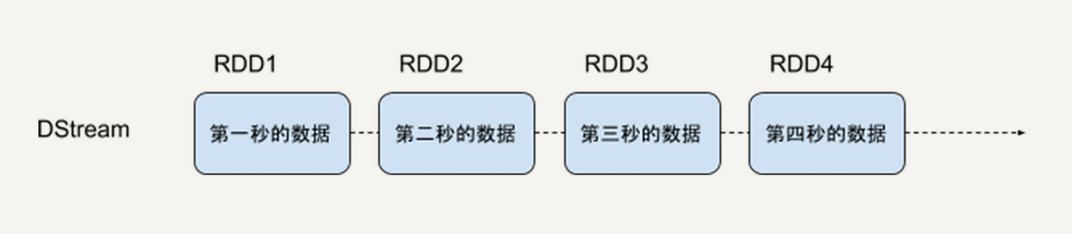
对 DStream 的转换操作,将对它所包含的每一个 RDD 进行同样的转换操作
1 | sc = SparkContext(master, appName) |
- 创建一个 lines DStream,监听来自本机 9999 端口的数据流,每一个数据代表一行文本
- 对 lines 进行 flatMap 操作,把每一个文本行拆分成词语
- 本质上,对一个 DStream 进行 flatMap 操作
- 就是对它里面的每一个 RDD 进行 flatMap 操作,生成一系列新的 RDD,构成一个新的 DStream
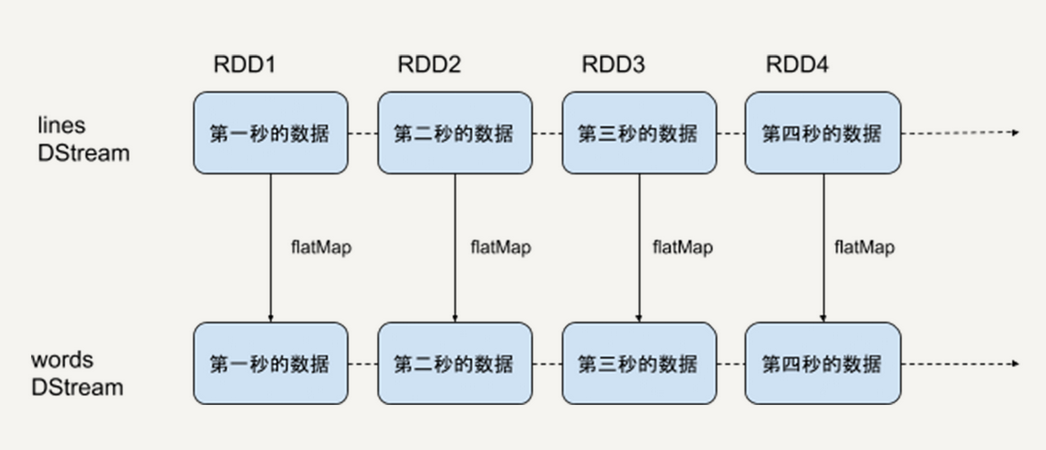
RDD 支持的所有的转换操作,DStream 都支持,但 DStream 还支持一些特有操作,如滑动窗口操作
滑动窗口
- 任何 Spark Streaming 程序都需要首先创建一个 StreamingContext 对象,是所有 Streaming 操作的入口
- 可以通过 StreamingContext 创建 DStream
- StreamingContext 中最重要的参数是批处理的时间间隔,即把流数据细分成数据块的粒度
- 该时间间隔决定了流处理的延迟性 - 需要根据需求和资源来衡量间隔的长度
- 滑动窗口 - 每隔一段时间,统计过去某个时间段内的数据
- 每隔 10 秒,输出过去 60 秒内排名前十的热点词
- 滑动窗口的基本参数
- 窗口长度(window length) - 每次统计的数据的时间跨度
- 滑动间隔(sliding interval)- 每次统计的时间间隔
- 由于 Spark Streaming 流处理的最小时间单位为 StreamingContext 的时间间隔
- 因此滑动窗口的两个参数都是 StreamingContext 时间间隔的整数倍

最基本的滑动窗口操作是 window,返回一个新的 DStream,其中的 RDD 代表一段时间窗口内的数据
1 | windowed_words = words.window(60, 10) |
- windowed_words 代表的是热词统计所需要的 DStream
- 里面每一个数据块都包含过去 60 秒内的词语,这样的数据块每 10 秒生成一个
优缺点
优点
- 底层基于 RDD 实现,能复用 RDD 的优良特性(如数据容错性、运行速度等)
- Spark Streaming 是 Spark 生态的一部分,可以与 Spark 核心引擎、Spark SQL、MLlib 等无缝衔接
缺点
- Spark Streaming 的主要缺点是实时计算延迟较高,一般在秒级
- 因为 Spark Streaming 不支持太小的批处理的时间间隔
- Spark Streaming 是一个准实时系统 - Apache Storm 可以做到毫秒级
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-09-21
Spark - Structured Streaming
背景 Spark Streaming 将无边界的流数据抽象成 DStream 按特定的时间间隔,把数据流分割成一个个 RDD 进行批处理 DStream API 与 RDD API 高度相似,拥有 RDD 的各种性质 DataSet/DataFrame DataSet/DataFrame 是高级 API,提供类似于 SQL 的查询接口,方便熟悉关系型数据库的开发人员使用 Spark SQL 执行引擎会自动优化 DataSet/DataFrame 程序 用 RDD API 开发的程序本质上需要开发人员手工构造 RDD 的 DAG 执行图,依赖于手工优化 如果拥有 DataSet/DataFrame API 的流处理模块 无需去用相对底层的 DStream API 去处理无边界数据,大大提升开发效率 在 2016 年,Spark 2.0 中推出结构化流处理的模块 - Structured Streaming Structured Streaming 基于 Spark SQL 引擎实现 在开发视角,流数据和静态数据没有区别,可以像批处理静态数据那样处理流...
2024-09-17
Spark - Overview
MapReduce概述 MapReduce 通过简单的 Map 和 Reduce 的抽象提供了一个编程模型 可以在一个由上百台机器组成的集群上并发处理大量的数据集,而把计算细节隐藏起来 各种各样的复杂数据处理都可以分解为 Map 和 Reduce 的基本元素 复杂的数据处理可以分解成由多个 Job(包含一个 Mapper 和一个 Reducer)组成的 DAG 然后,将每个 Mapper 和 Reducer 放到 Hadoop 集群上执行,得到最终结果 不足 高昂的维护成本 时间性能不达标 MapReduce 模型的抽象层次低 大量的底层逻辑需要开发者手工完成 - 用汇编语言开发游戏 只提供 Map 和 Reduce 操作 很多现实的数据处理场景并不适合用这个模型来描述 实现复杂的操作需要技巧,让整个工程变得庞大且难以维护 维护一个多任务协调的状态机成本很高,且扩展性很差 在 Hadoop 中,每个 Job 的计算结果都会存储在 HDFS 文件存储系统中 每一步计算都要进行硬盘的读取和写入,大大增加了系统的延迟 MapReduce 对于迭代算法的处理性能很差,而且非常耗资源 因...
2024-09-18
Spark - RDD
分布式内存 传统的 MapReduce 框架运行缓慢,主要原因是 DAG 的中间计算结果需要写入硬盘来防止运行结果丢失 每次调用中间计算结果都需要进行一次硬盘的读取 反复对硬盘进行读写操作以及潜在的数据复制和序列化操作会大大地提高了计算延迟 新的分布式存储方案 - 保持之前系统的稳定性、错误恢复和可扩展性,并尽可能地减少硬盘 IO 操作 RDD 是基于分布式内存的数据抽象,不仅支持基于工作集的应用,同时具有数据流模型的特点 定义分区 分区代表同一个 RDD 包含的数据被存储在系统的不同节点上,这是可以被并行处理的前提 在逻辑上,可以认为 RDD 是一个大数组,数组中的每个元素代表一个分区(Partition) 在物理存储中,每个分区指向一个存放在内存或者硬盘中的数据块(Block) Block 是独立的,可以被存放在分布式系统中的不同节点 RDD 只是抽象意义的数据集合,分区内部并不会存储具体的数据 RDD 中的每个分区都有它在该 RDD 中的 Index 通过 RDD_ID 和 Partition_Index 可以唯一确定对应 Block 的编号 从而通过底层存储层的接口中提取...
2024-09-22
Big Data - Spark + Flink
Spark 实时性 无论是 Spark Streaming 还是 Structured Streaming,Spark 流处理的实时性还不够 无法应对实时性要求很高的流处理场景 Spark 的流处理是基于微批处理的思想 把流处理看做批处理的一种特殊形式,没接收到一个时间间隔的数据才会去处理 虽然在 Spark 2.3 中提出连续处理模型,但只支持有限的功能,并不能在大项目中使用 要在流处理的实时性提升,就不能继续用微批处理的模式,而是有数据数据就立即处理,不做等待 Apache Flink 采用了基于操作符(Operator)的连续流模型,可以做到微秒级别的延迟 Flink模型 Flink 中最核心的数据结构是 Stream,代表一个运行在多个分区上的并行流 在 Stream 上可以进行各种转换(Transformation)操作 与 Spark RDD 不同的是,Stream 代表一个数据流而不是静态数据的集合 Stream 所包含的数据随着时间增长而变化的 而且 Stream 上的转换操作都是逐条进行的 - 每当有新数据进入,整个流程都会被执行并更新结果 Flink 比 Spark...
2024-09-19
Spark - SQL
历史Hive 一开始,Hadoop/MapReduce 在企业生产中大量使用,在 HDFS 上积累了大量数据 MapReduce 对于开发者而言使用难度较大,大部分开发人员最熟悉的还是传统的关系型数据库 为了方便大多数开发人员使用 Hadoop,诞生了 Hive Hive 提供类似 SQL 的编程接口,HQL 经过语法解析、逻辑计划、物理计划转化成 MapReduce 程序执行 使得开发人员很容易对 HDFS 上存储的数据进行查询和分析 Shark 在 Spark 刚问世时,Spark 团队开发了 Shark 来支持用 SQL 来查询 Spark 的数据 Shark 的本质是 Hive,Shark 修改了 Hive 的内存管理模块,大幅优化了运行速度 Shark 依赖于 Hive,严重影响了 Spark 的发展,Spark 要定义一个统一的技术栈和完整的生态 依赖于 Hive 还会制约 Spark 各个组件的相互集成,Spark 无法利用 Spark 的特性进行深度优化 2014 年 7 月 1 日,Spark 团队将 Shark 交给 Hive 进行管理,即 Hive on Spa...
2024-10-03
Beam - Window
Window 在 Beam 中,Window 将 PCollection 里的每个元素根据时间戳划分成不同的有限数据集合 要将一些聚合操作应用在 PCollection 上时,或者对不同的 PCollection 进行 Join 操作 Beam 将这些操作应用在这些被 Window 划分好的不同的数据集上 无论是有界数据还是无界数据,Beam 都会按同样的规则进行处理 在用 IO Connector 读取有界数据集的过程中,Read Transform 会默认为每个元素分配一个相同的时间戳 一般情况下,该时间戳为运行 Pipeline 的时间,即处理时间 - Processing Time Beam 会为该 Pipeline 默认分配一个全局窗口 - Global Window - 从无限小到无限大的时间窗口 Global Window 可以显式将一个全局窗口赋予一个有界数据集 12PCollection<String> input = p.apply(TextIO.read().from(filepath));PCollection<String> batchI...