Big Data - Spark + Flink
Spark 实时性
- 无论是 Spark Streaming 还是 Structured Streaming,Spark 流处理的实时性还不够
- 无法应对实时性要求很高的流处理场景
- Spark 的流处理是基于微批处理的思想
- 把流处理看做批处理的一种特殊形式,没接收到一个时间间隔的数据才会去处理
- 虽然在 Spark 2.3 中提出连续处理模型,但只支持有限的功能,并不能在大项目中使用
- 要在流处理的实时性提升,就不能继续用微批处理的模式,而是有数据数据就立即处理,不做等待
- Apache Flink 采用了基于操作符(Operator)的连续流模型,可以做到微秒级别的延迟
Flink
模型
- Flink 中最核心的数据结构是 Stream,代表一个运行在多个分区上的并行流
- 在 Stream 上可以进行各种转换(Transformation)操作
- 与 Spark RDD 不同的是,Stream 代表一个数据流而不是静态数据的集合
- Stream 所包含的数据随着时间增长而变化的
- 而且 Stream 上的转换操作都是逐条进行的 - 每当有新数据进入,整个流程都会被执行并更新结果
- Flink 比 Spark Streaming 有更低的流处理延迟性
当一个 Flink 程序被执行时,会被映射为 Streaming Dataflow
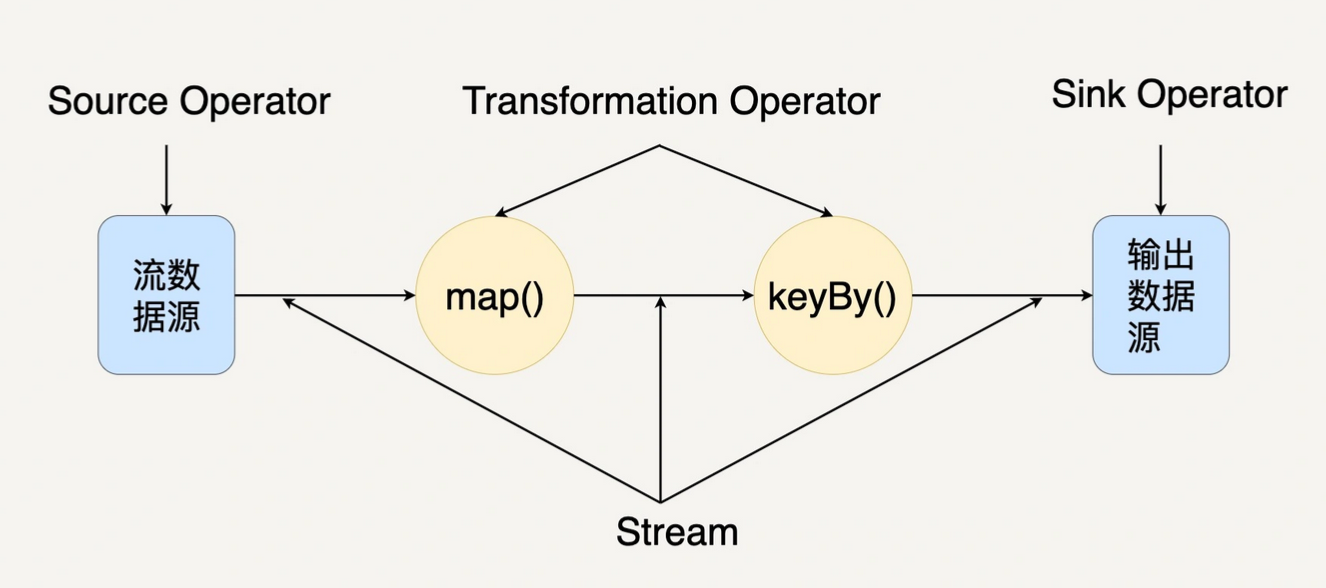
- Streaming Dataflow 包括 Stream 和 Operator
- 转换操作符(Transformation Operator)把一个或多个 Stream 转换成多个 Stream
- 每个 Streaming Dataflow 都有一个输入数据源(Source)和一个输出数据源(Sink)
- Streaming Dataflow 与 Spark RDD DAG 类似,会被组合成一个 DAG 去执行
在 Flink 中,程序天生就是并行和分布式的
- 一个 Stream 可以包含多个分区(Stream Partitions)
- 一个 Operator 可以被分成多个 Operator 子任务
- 每一个子任务在不同的线程或者不同的节点上独立执行
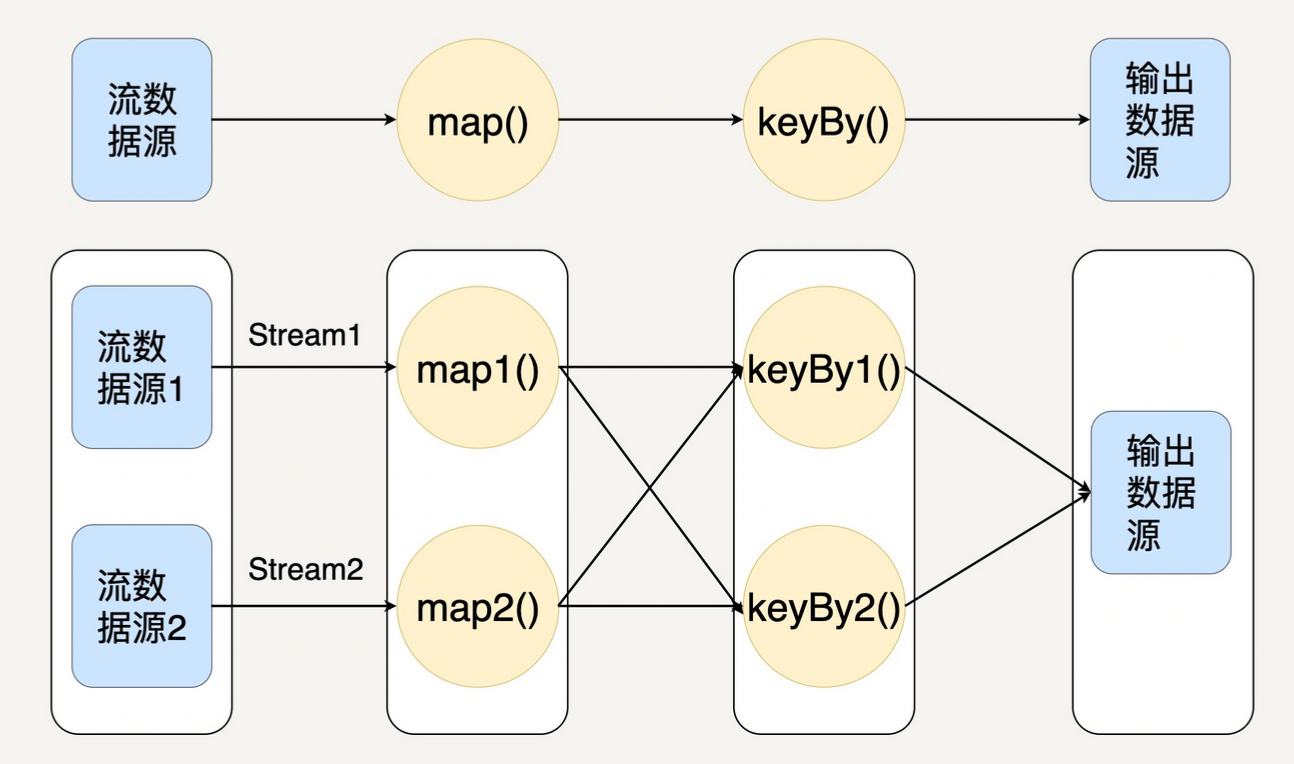
Stream 在 Operator 之间传输数据的形式有两种
- 一对一(One-to-one)
- Stream 维护着分区和元素的顺序
- Map Operator 的子任务处理的数据和 Source 的子任务生产的元素的数据相同
- 与 Spark RDD 窄依赖非常类似
- 重新分布(Redistributing)
- Stream 中数据的分区会发生改变
- Operator 的每个子任务把数据发送到不同的目标子任务上
架构
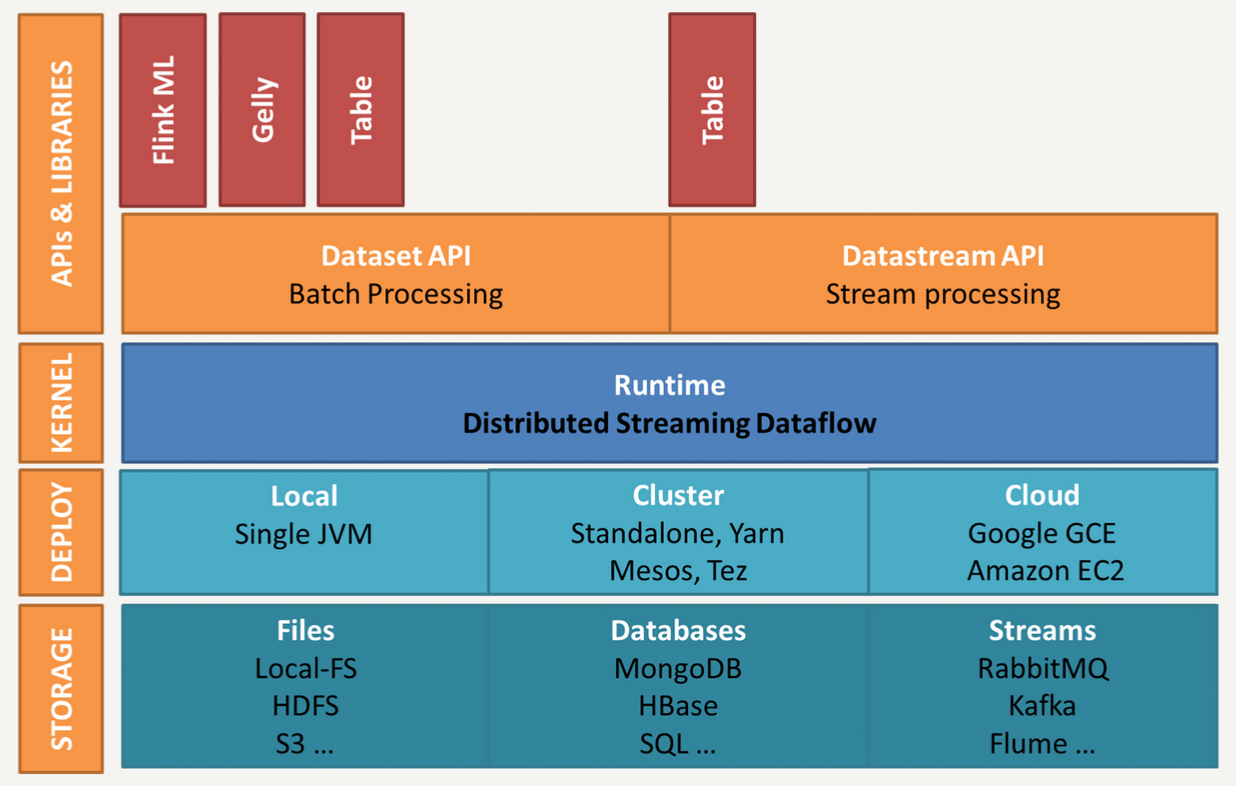
- 核心处理引擎是 Distributed Streaming Dataflow
- 所有高级 API 和应用库都会被翻译成包含 Stream 和 Operator 的 Streaming Dataflow
- Flink 提供两个核心的 API - DataSet API 和 DataStream API
- 与 Spark 的 DataSet 和 DataFrame 非常类似
- DataSet 代表有界的数据集,而 DataStream 代表流数据
- DataSet API 用来做批处理,而 DataStream API 用来做流处理
- 在 Flink 内部,DataSet 其实也是用 Stream 表示
- 静态的有界数据可以被看作特殊的流数据 – 刚好与 Spark 相反
- DataSet 与 DataStream 可以无缝切换 - Flink 的核心是 DataStream
- DataSet 和 DataStream 都支持各种基本的转换操作 - map、filter、count、groupBy 等
- Flink 是用 Java 开发的,对 Java 有原生的支持,也可以用 Scala 开发 Flink 程序
- 在 Flink 1.0 后支持了 Python
- Flink DataStream 的使用方法与 Spark RDD 类似
- 把程序拆分成一系列的转换操作并分布式地执行
- 在 DataSet 和 DataStream 之上,有更高层次的 Table API
- Flink Table API 与 Spark SQL 的思想类似,是关系型的 API
- 可以像操作 SQL 数据库表那样操作数据,而不需要通过操作 DataStream/DataSet 的方式进行数据处理
- 更不需要手动优化代码的执行逻辑
- 跟 Spark SQL 类似,Flink Table API 同样统一了 Flink 的批处理和流处理
Flink vs Spark
Flink 和 Spark 都支持批处理和流处理
相同点
- 都是基于内存计算
- 都有统一的批处理和流处理的 API,都支持类似 SQL 的编程接口
- 都支持很多相同的转换操作,编程都是用类似 Scala Collection API 的函数式编程模式
- 都有完善的错误恢复机制
- 都支持 Exactly once 的语义一致性
差异点
流处理
Flink
- Spark 是基于微批处理
- 把流数据看成一个个小的批处理数据块分别处理,延迟性只能做到秒级
- Spark 只支持基于时间的窗口处理(处理时间或者事件时间)
- Flink 是基于每个事件处理
- 每当有新的数据输入都会立刻处理,是真正的流式计算,支持毫秒级计算
- Flink 支持的窗口操作非常灵活,不仅支持时间窗口,还支持基于数据本身的窗口
SQL
Spark
- Spark 和 Flink 分别提供 Spark SQL 和 Table API 提供 SQL 支持
- Spark 对 SQL 支持更好,相应的优化、扩展和性能更好
迭代计算
Flink
- Spark 对机器学习的支持很好,可以在内存中缓存中间计算结果来加速机器学习算法的运行
- 但大部分机器学习算法其实是个有环的数据流,在 Spark 中,却是用无环图来表示
- Flink 支持在运行时间中的有环数据流,从而可以更有效地对机器学习算法进行运算
生态
Spark
- Spark 社区更活跃,各种扩展库也更全面
场景
Spark
- 数据量非常大而且逻辑复杂的批处理,并且对计算效率有较高要求
- 基于历史数据的交互式查询,要求响应较快
- 基于实时数据流的数据处理,延迟性要求在百毫秒到数秒之间
Flink
- Flink 是为了提升流处理而创建的平台,适用于各种需要非常低延迟的实时数据处理场景 - 实时日志分析
- Flink 是用流处理去模拟批处理的思想,比 Spark 用批处理去模拟流处理的思想扩展性更好
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-09-19
Spark - SQL
历史Hive 一开始,Hadoop/MapReduce 在企业生产中大量使用,在 HDFS 上积累了大量数据 MapReduce 对于开发者而言使用难度较大,大部分开发人员最熟悉的还是传统的关系型数据库 为了方便大多数开发人员使用 Hadoop,诞生了 Hive Hive 提供类似 SQL 的编程接口,HQL 经过语法解析、逻辑计划、物理计划转化成 MapReduce 程序执行 使得开发人员很容易对 HDFS 上存储的数据进行查询和分析 Shark 在 Spark 刚问世时,Spark 团队开发了 Shark 来支持用 SQL 来查询 Spark 的数据 Shark 的本质是 Hive,Shark 修改了 Hive 的内存管理模块,大幅优化了运行速度 Shark 依赖于 Hive,严重影响了 Spark 的发展,Spark 要定义一个统一的技术栈和完整的生态 依赖于 Hive 还会制约 Spark 各个组件的相互集成,Spark 无法利用 Spark 的特性进行深度优化 2014 年 7 月 1 日,Spark 团队将 Shark 交给 Hive 进行管理,即 Hive on Spa...
2024-09-18
Spark - RDD
分布式内存 传统的 MapReduce 框架运行缓慢,主要原因是 DAG 的中间计算结果需要写入硬盘来防止运行结果丢失 每次调用中间计算结果都需要进行一次硬盘的读取 反复对硬盘进行读写操作以及潜在的数据复制和序列化操作会大大地提高了计算延迟 新的分布式存储方案 - 保持之前系统的稳定性、错误恢复和可扩展性,并尽可能地减少硬盘 IO 操作 RDD 是基于分布式内存的数据抽象,不仅支持基于工作集的应用,同时具有数据流模型的特点 定义分区 分区代表同一个 RDD 包含的数据被存储在系统的不同节点上,这是可以被并行处理的前提 在逻辑上,可以认为 RDD 是一个大数组,数组中的每个元素代表一个分区(Partition) 在物理存储中,每个分区指向一个存放在内存或者硬盘中的数据块(Block) Block 是独立的,可以被存放在分布式系统中的不同节点 RDD 只是抽象意义的数据集合,分区内部并不会存储具体的数据 RDD 中的每个分区都有它在该 RDD 中的 Index 通过 RDD_ID 和 Partition_Index 可以唯一确定对应 Block 的编号 从而通过底层存储层的接口中提取...
2024-09-20
Spark - Streaming
流处理 Spark SQL 中的 DataFrame API 和 DataSet API 都是基于批处理模式对静态数据进行处理 在 2013,Spark 的流处理组件 Spark Streaming 发布,现在的 Spark Streaming 已经非常成熟,应用非常广泛 原理 Spark Streaming 的原理与微积分的思想很类似 微分是无限细分,而积分是对无限细分的每一段进行求和 本质 - 将一个连续的问题转换成了无限个离散的问题 流处理的数据是一系列连续不断变化,且无边界的,永远无法预测下一秒的数据 Spark Streaming 用时间片拆分了无限的数据流 然后对每个数据片用类似于批处理的方法进行处理,输出的数据也是分块的 Spark Streaming 提供一个对于流数据的抽象 DStream DStream 可以由 Kafka、Flume 或者 HDFS 的流数据生成,也可以由别的 DStream 经过各种转换操作得到 底层 DStream 由多个序列化的 RDD 构成,按时间片(如一秒)切分成的每个数据单位都是一个 RDD Spark 核心引擎将对 DStream ...
2024-09-21
Spark - Structured Streaming
背景 Spark Streaming 将无边界的流数据抽象成 DStream 按特定的时间间隔,把数据流分割成一个个 RDD 进行批处理 DStream API 与 RDD API 高度相似,拥有 RDD 的各种性质 DataSet/DataFrame DataSet/DataFrame 是高级 API,提供类似于 SQL 的查询接口,方便熟悉关系型数据库的开发人员使用 Spark SQL 执行引擎会自动优化 DataSet/DataFrame 程序 用 RDD API 开发的程序本质上需要开发人员手工构造 RDD 的 DAG 执行图,依赖于手工优化 如果拥有 DataSet/DataFrame API 的流处理模块 无需去用相对底层的 DStream API 去处理无边界数据,大大提升开发效率 在 2016 年,Spark 2.0 中推出结构化流处理的模块 - Structured Streaming Structured Streaming 基于 Spark SQL 引擎实现 在开发视角,流数据和静态数据没有区别,可以像批处理静态数据那样处理流...
2024-09-17
Spark - Overview
MapReduce概述 MapReduce 通过简单的 Map 和 Reduce 的抽象提供了一个编程模型 可以在一个由上百台机器组成的集群上并发处理大量的数据集,而把计算细节隐藏起来 各种各样的复杂数据处理都可以分解为 Map 和 Reduce 的基本元素 复杂的数据处理可以分解成由多个 Job(包含一个 Mapper 和一个 Reducer)组成的 DAG 然后,将每个 Mapper 和 Reducer 放到 Hadoop 集群上执行,得到最终结果 不足 高昂的维护成本 时间性能不达标 MapReduce 模型的抽象层次低 大量的底层逻辑需要开发者手工完成 - 用汇编语言开发游戏 只提供 Map 和 Reduce 操作 很多现实的数据处理场景并不适合用这个模型来描述 实现复杂的操作需要技巧,让整个工程变得庞大且难以维护 维护一个多任务协调的状态机成本很高,且扩展性很差 在 Hadoop 中,每个 Job 的计算结果都会存储在 HDFS 文件存储系统中 每一步计算都要进行硬盘的读取和写入,大大增加了系统的延迟 MapReduce 对于迭代算法的处理性能很差,而且非常耗资源 因...
2024-09-26
Beam - Transform
DAG Transform 是 Beam 中数据处理的最基本单元 Beam 把数据转换抽象成有向图 反直觉 - PCollection 是有向图中的边,而 Transform 是有向图中的节点 区分节点和边的关键是看一个 Transform 是不是有一个多余的输入和输出 每个 Transform 都可能有大于一个的输入 PCollection,也可能输出大于一个的输出 PCollection Apply Beam 中的 PCollection 有一个抽象的成员函数 Apply,使用任何一个 Transform 时,都需要调用 Apply 123final_collection = input_collection.apply(Transform1).apply(Transform2).apply(Transform3) Transform概述 ParDo - Parallel Do - 表达的是很通用的并行处理数据操作 GroupByKey - 把一个 Key/Value 的数据集按照 Key 归并 可以用 ParDo 实现 GroupByKey 简单实现 - 放...