Beam - Future
技术迭代
- 2006,Apache Hadoop 发布,基于 MapReduce 计算模型
- 2009,Spark 计算框架在 加州伯克利大学诞生,于 2010 年开源,于 2014 年成为 Apache 的顶级项目
- Spark 的数据处理效率远在 Hadoop 之上
- 2014,Flink 面世,流批一体,于 2018 年被阿里收购
Apache Beam
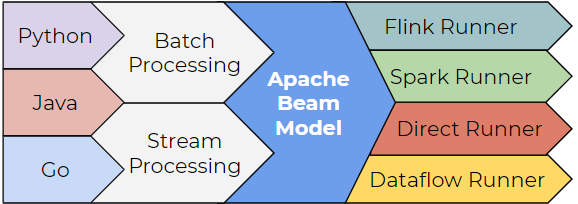
- Apache Beam 根据 Dataflow Model API 实现的,能完全胜任批流一体的任务
- Apache Beam 有中间的抽象转换层,工程师无需学习新 Runner 的 API 的语法,减少学习新技术的时间成本
- Runner 可以专心优化效率和迭代功能,而不必担心迁移
Beam Runner
- 迭代非常快 - 如 Flink
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-09-23
Beam - Context
MapReduce架构思想 提供一套简洁的 API 来表达工程师数据处理的逻辑 在这套 API 底层嵌套一套扩展性很强的容错系统 计算模型 Map 计算模型从输入源中读取数据集合 这些数据经过用户所写的逻辑后生成一个临时的键值对数据集 MapReduce 计算模型会将拥有相同键的数据集集中起来发送到下一阶段,即 Shuffle 阶段 Reduce 接收从 Shuffle 阶段发送过来的数据集 在经过用户所写的逻辑后生成零个或多个结果 划时代意义 Map 和 Reduce 这两种抽象,其实可以适用于非常多的应用场景 MapReduce 的容错系统,可以让数据处理逻辑在分布式环境下有很好的扩展性(Scalability) 不足 使用 MapReduce 来解决一个工程问题,往往会涉及非常多的步骤 每次使用 MapReduce 时,都需要在分布式环境中启动机器来完成 Map 和 Reduce 步骤 并且需要启动 Master 机器来协调两个步骤的中间结果,存在不少的硬件资源开销 FlumeJava 将所有的数据都抽象成名为 PCollection 的数据结构 无论是从内存中读取的数据,...
2024-09-28
Beam - Pipeline IO
读取数据集 一个输入数据集的读取通常是通过 Read Transform 来完成 Read Transform 从外部源读取数据 - 本地文件、数据库、OSS、MQ Read Transform 返回一个 PCollection,该 PCollection 可以作为一个输入数据集,应用在各种 Transform 上 Pipeline 没有限制调用 Read Transform 的时机 可以在 Pipeline 最开始的时候调用 也可以在经过 N 个步骤的 Transforms 后再调用它来读取另外的数据集 本地文件 1PCollection<String> inputs = p.apply(TextIO.read().from(filepath)); Beam 支持从多个文件路径中读取数据集,文件名匹配规则与 Linux glob 一样 glob 操作符的匹配规则最终要和所使用的底层文件系统挂钩 从不同的外部源读取同一类型的数据来统一作为输入数据集 - 利用 flatten 操作将数据集合并 12345PCollection<String> input1 ...
2024-09-30
Beam - Pipeline Test
Context 设计好的 Pipeline 通常需要放在分布式环境下执行,具体每一步的 Transform 都会被分配到任意机器上执行 如果 Pipeline 运行出错,则需要定位到具体机器,再到上面去做调试是不现实的 另一种办法,读取一些样本数据集,再运行整个 Pipeline 去验证哪一步逻辑出错 - 费时费力 正式将 Pipeline 放在分布式环境上运行之前,需要先完整地测试整个 Pipeline 逻辑 Solution Beam 提供了一套完整的测试 SDK 可以在开发 Pipeline 的同时,能够实现对一个 Transform 逻辑的单元测试 也可以对整个 Pipeline 的 End-to-End 测试 在 Beam 所支持的各种 Runners 中,有一个 DirectRunner DirectRunner 即本地机器,整个 Pipeline 会放在本地机器上运行 DoFnTester - 让用户传入一个自定义函数来进行测试 - UDF - User Defined Function DoFnTester 接收的对象是用户继承实现的 DoFn 不应该将 DoFn 当成...
2024-09-27
Beam - Pipeline
创建 在 Beam 中,所有的数据处理逻辑都会被抽象成 Pipeline 来运行 Pipeline 是对数据处理逻辑的一个封装 包括一整套流程 - 读取数据集、将数据集转换成想要的结果、输出结果数据集 创建 Pipeline 12PipelineOptions options = PipelineOptionsFactory.create();Pipeline p = Pipeline.create(options); 应用 PCollection 具有不可变性 一个 PCollection 一旦生成,就不能在增加或者删除里面的元素了 在 Beam 中,每次 PCollection 经过一个 Transform 之后,Pipeline 都会创建一个新的 PCollection 新创建的 PCollection 又成为下一个 Transform 的输入 原先的 PCollection 不会有任何改变 对同一个 PCollection 可以应用多种不同的 Transform 处理模型 Pipeline 的底层思想依然是 MapReduce 在分布式环境下,整个 Pipeline...
2024-10-03
Beam - Window
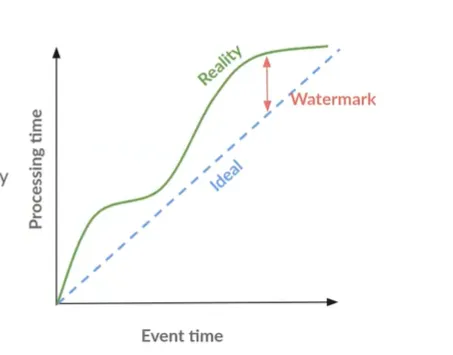
Window 在 Beam 中,Window 将 PCollection 里的每个元素根据时间戳划分成不同的有限数据集合 要将一些聚合操作应用在 PCollection 上时,或者对不同的 PCollection 进行 Join 操作 Beam 将这些操作应用在这些被 Window 划分好的不同的数据集上 无论是有界数据还是无界数据,Beam 都会按同样的规则进行处理 在用 IO Connector 读取有界数据集的过程中,Read Transform 会默认为每个元素分配一个相同的时间戳 一般情况下,该时间戳为运行 Pipeline 的时间,即处理时间 - Processing Time Beam 会为该 Pipeline 默认分配一个全局窗口 - Global Window - 从无限小到无限大的时间窗口 Global Window 可以显式将一个全局窗口赋予一个有界数据集 12PCollection<String> input = p.apply(TextIO.read().from(filepath));PCollection<String> batchI...
2024-10-02
Beam - WordCount
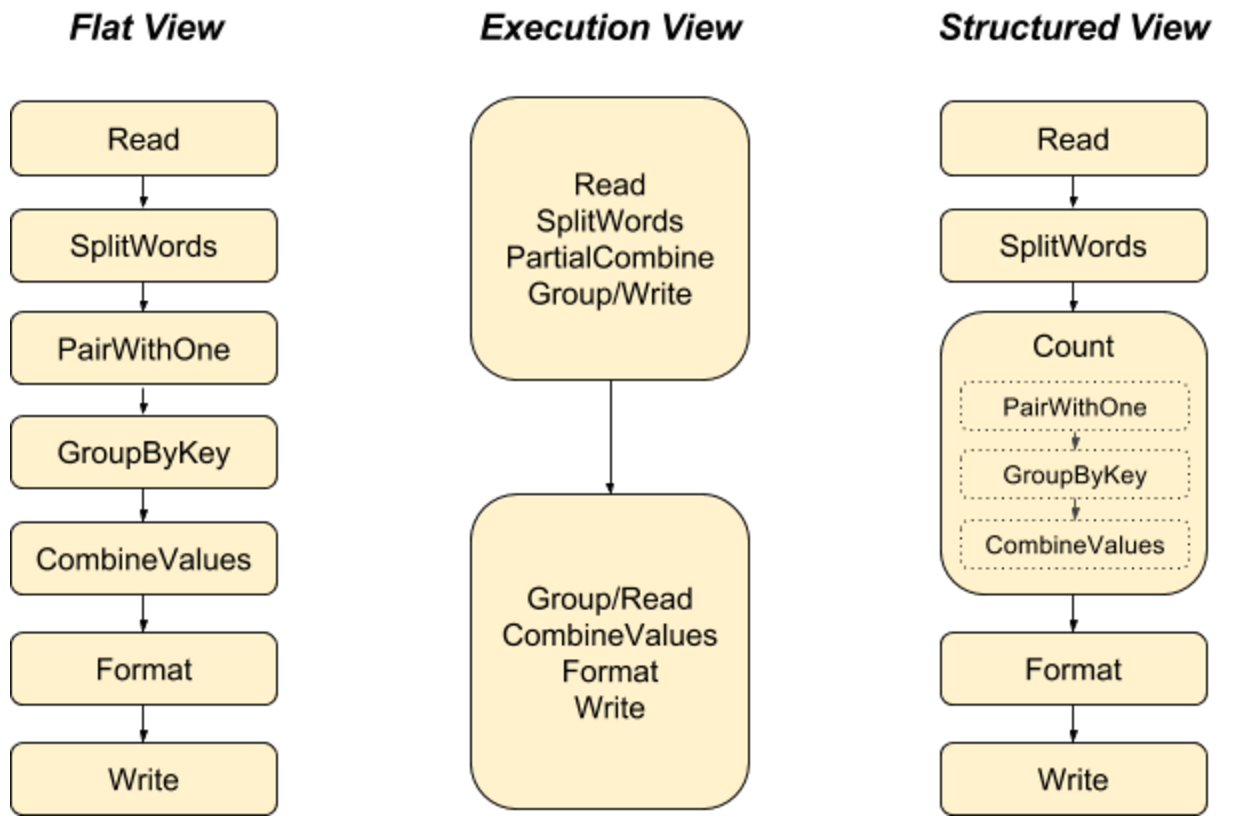
步骤 用 Pipeline IO 读取文本 用 Transform 对文本进行分词和词频统计 用 Pipeline IO 输出结果 将所有步骤打包成一个 Pipeline 创建 Pipeline 默认情况下,将采用 DirectRunner 在本地运行 1PipelineOptions options = PipelineOptionsFactory.create(); 一个 Pipeline 实例会构建数据处理的 DAG,以及这个 DAG 所需要的 Transform 1Pipeline p = Pipeline.create(options); 应用 Transform TextIO.Read - 读取外部文件,生成一个 PCollection,包含所有文本行,每个元素都是文本中的一行 123String filepattern = "file:///Users/zhongmingmao/workspace/java/hello-beam/corpus/shakespeare.txt";PCollection<String> lines = ...