MQ - Concept
消息管道
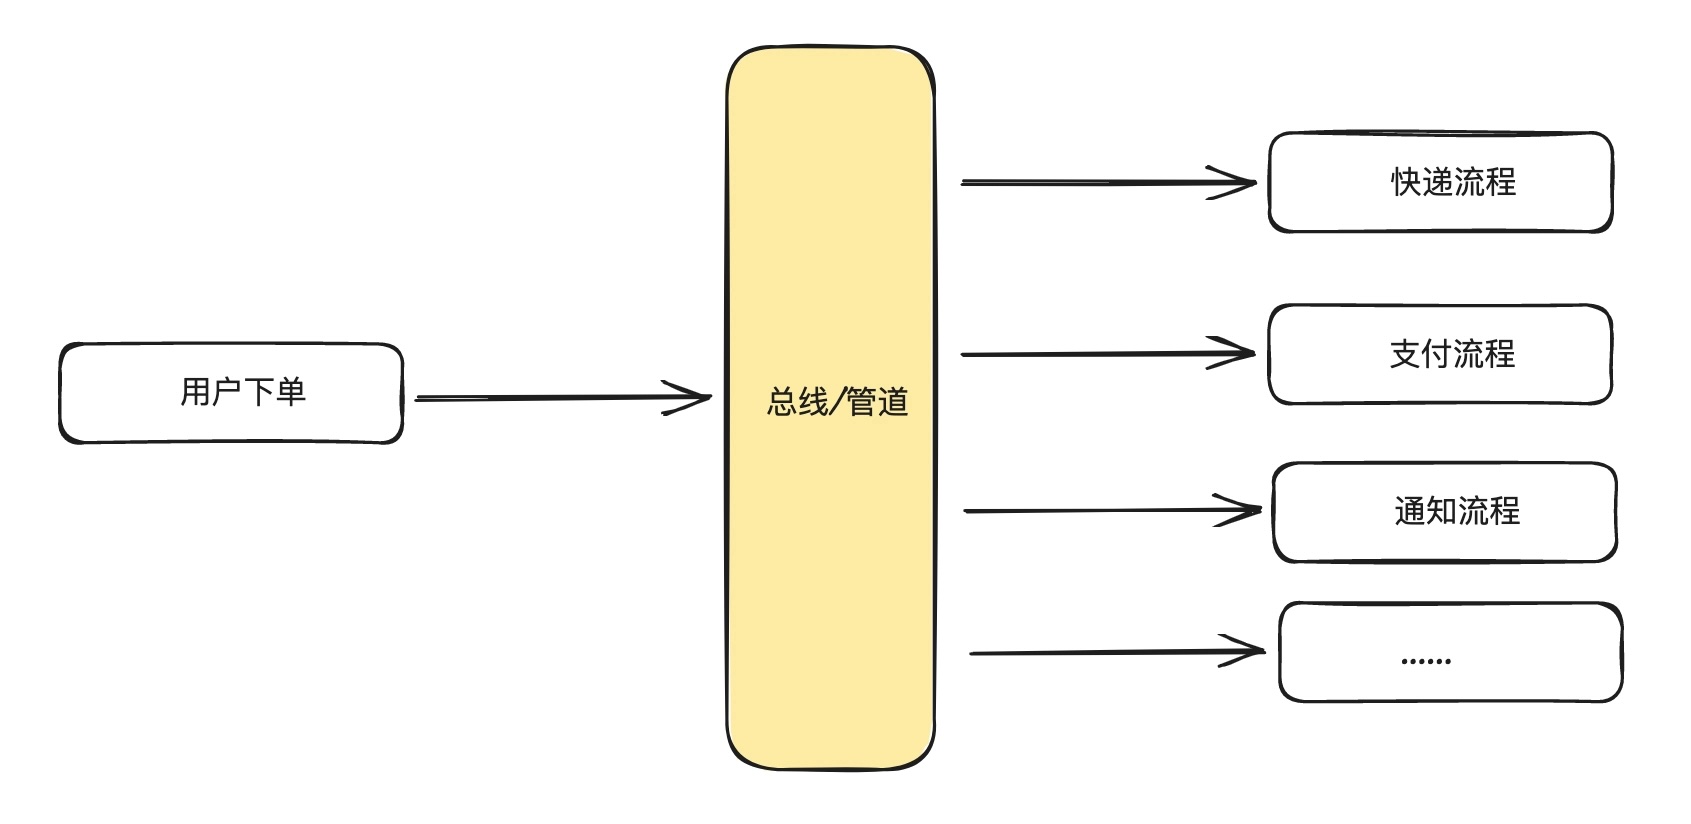
在系统架构中,MQ 的定位是消息和管道,主要起到解耦上下游系统,数据缓存的作用,主要操作为生产和消息
架构
Broker
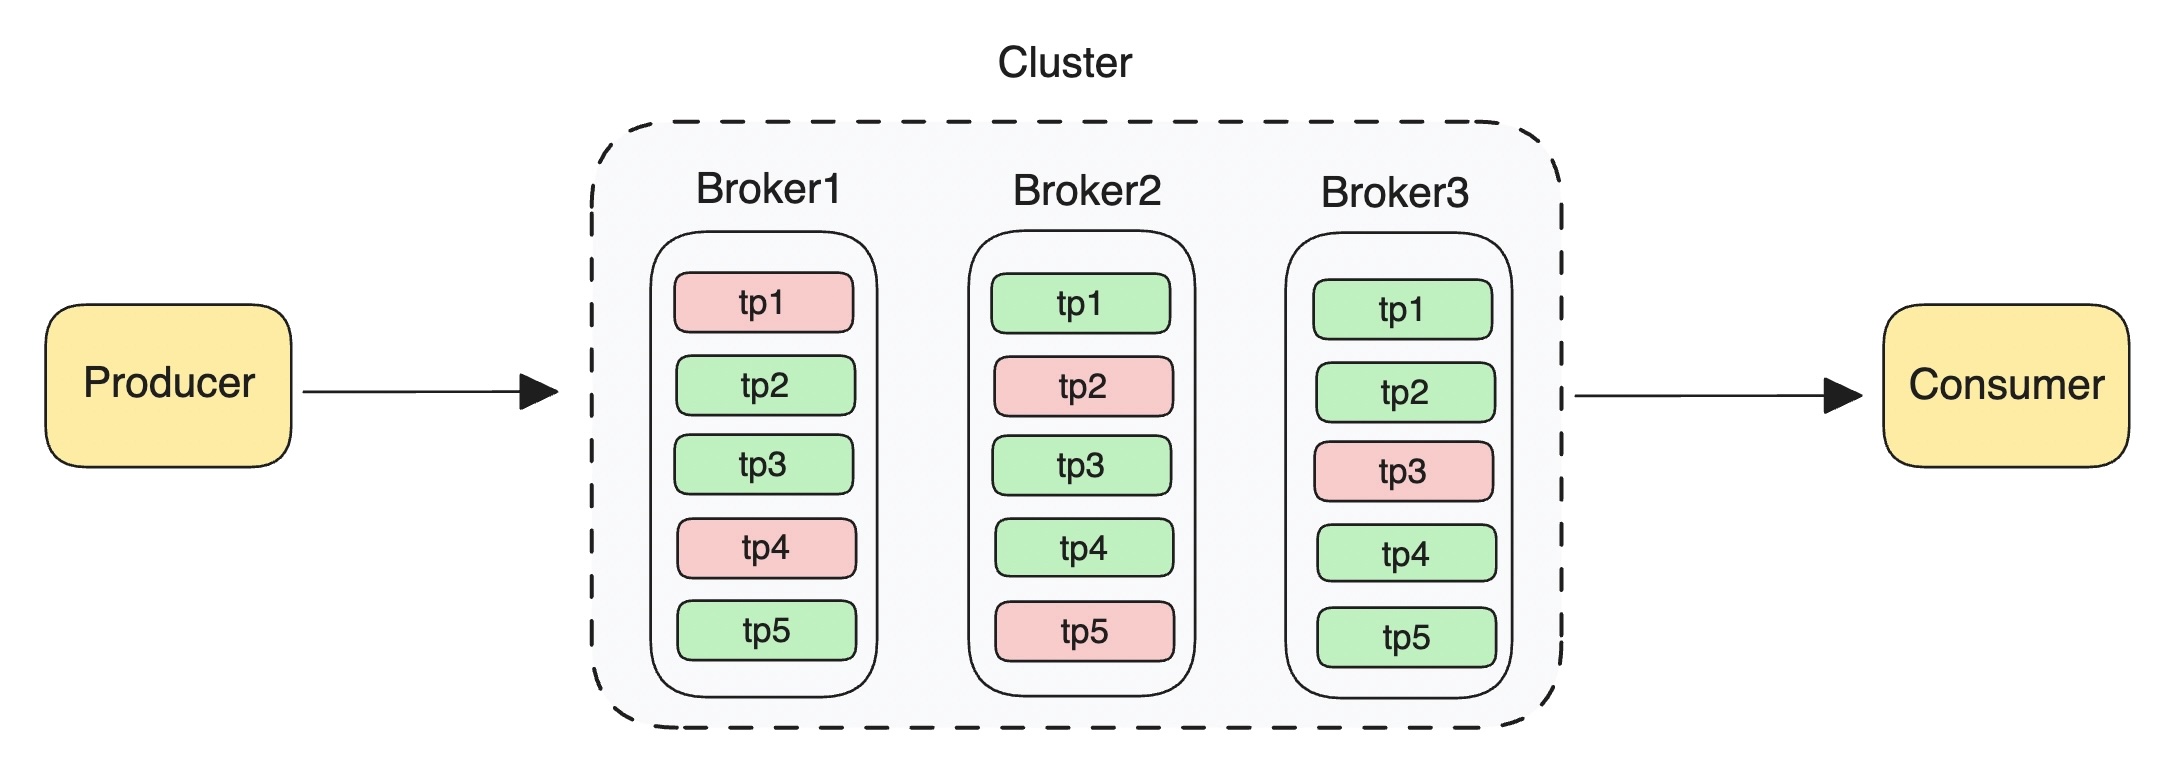
- Broker 本质上是一个进程
- 在实际部署过程中,通常一个物理节点只会起一个进程,在大部分情况下,Broker 表示一个节点
Topic
- 在大部分 MQ 中,Topic 都是用来组织分区关系的一个逻辑概念
- 通常情况下,一个 Topic 会包含多个分区
- 在 RabbitMQ 中,Topic 是指具体的一种主题模式
Partition
Queue / MessageQueue
- 在 MQ 中,分区、分片、Partition、Queue、MessageQueue 是一个概念,用来表示数据存储的最小单位
- 可以将消息写入到一个分区中,也可以将消息写入到 Topic 中,再分发到具体的某个分区
- 一个 Topic 通常会包含一个或多个分区
Producer
- 消息的发送方,即发送消息的客户端
Consumer
- 消息的接收方,即接收消息的客户端
ConsumerGroup
Subscription
- 一般情况下,MQ 中的 ConsumerGroup 和 Subscription 是同一概念
- 用来组织消费者和分区关系的逻辑概念,也可用于保存消费进度
Message
- 一条真实的业务数据,MQ 中的每条数据一般都叫做一条消息
Offset
ConsumerOffset / Cursor
- 指消费者消费分区的进度
- 每个消费者都会去消费分区,为了避免重复消费,都会保存消费者消费分区的进度信息
ACK
OffsetCommit
- 提交消费进度的操作,即数据消费成功后,提交当前的消费位点,确保不重复消费
Leader + Follower
- Leader 和 Follower 一般是分区维度副本的概念
- 一个分区一般会有多个副本,副本有主从概念,一般是一个主副本和多个从副本
Segment
- 指消息数据在底层具体存储时,分为多个文件存储时的文件,该文件叫做分区的数据段
- 如每超过 1G 的文件就新起一个文件来存储,即 Segment
- 几乎所有的 MQ 都有 Segment 的概念,如 Kafka 的 Segment,Pulsar 的 Ledger
StartOffset + EndOffset
- StartOffset 和 EndOffset 是分区维度的概念
- 数据是顺序写入分区的,一般从 0 位置开始往后写,此时 StartOffset 为 0
- 数据会过期,分区维度较早的数据会被清理,此时 StartOffset 会往后移,表示当前最早的有效数据的位点
- EndOffset 即最新的那条数据的写入位点
- StartOffset 和 EndOffset 是一直动态变化的
ACL
- 用来对集群中的资源进行权限控制,如控制 Topic 或 Partition 的读写操作等
功能
顺序消息
- Consumer 按 Producer 写入的顺序来消费消息
延时消息
定时消息
- Producer 发送消息到 Broker 时,设置该消息在多久后会被消费到,当时间到了,消息会被消费到
- 延时以 Broker 收到消息的时间为准,多久后消息能被 Consumer 消费
- 定时是指消息在设置的时间才能被看到
- 在技术上,延时和定时是一样的
事务消息
- 不同的 MQ 关于事务的定义,也是不太一样的
- 正常情况下,事务表示多个操作的原子性
- 在 MQ 中,一般指的是发送一批消息,要么同时成功,要么同时失败
消息重试
- Producer 重试 - 当消息发送失败后,可以设置重试策略
- Consumer 重试 - 当消费的消息处理失败后,会自动重试消费消息
消息回溯
- 消息可以被多次消费
- 某条消息消费成功后,该消息不会被删除,后续还能再重复消费到该消息
广播消费
- 一条消息可以被多个消费者消费
死信队列
- 当某条消息无法成功处理时,把该消息写入到一个死信队列中,继续处理后续消息
- 大部分情况下,死信队列在 Consumer 中使用
优先级队列
- 给 Partition 中消息设置权重,权重大的消息能够被优先消费到
- 大部分情况下,MQ 的消息处理是 FIFO 的规则
- 优先级是在消息维度设置的
消息过滤
- 给每条消息打上 Tag,在消费的时候根据 Tag 去消费消息
- 通过 Tag 去查询过滤消息 - 在 Consumer 端
TTL
- MQ 中的消息会在一定时间或者超过一定大小后会被删除
- MQ 的主要是缓冲作用,一般会要求消息在一定的策略后自动被清理
消息轨迹
- 记录一条消息从 Producer 发送、Broker 保存、Consumer 消费的全生命周期的流程信息
消息查询
- 根据某些信息查询到消息队列中的信息
- 根据消息 ID 或者消费位点来查询消息 - SQL Select
消息压缩
- Producer 发送消息的时候,是否支持将消息进行压缩,以节省物理资源
- 压缩可以在 Producer 完成,也可以在 Broker 完成,一般会在 Producer 完成
多租户
- 同一个集群存在逻辑隔离
- Namespace / Tenant
消息持久化
- 消息被发送到 Broker 后,会不会持久化存储
- 有些 MQ 为了保证性能,只会把消息存储在内存中,在节点重启后,数据会丢失
消息流控
- 对读写集群的消息进行限制
- 限流维度 - Topic / Partition / ConsumerGroup 等
选型
业务消息 - RocketMQ
流消息 - Kafka
RabbitMQ + RocketMQ
业务消息 - 及时性、更多的功能特性、消息可追踪
- RabbitMQ 和 RocketMQ 属于业务消息类的 MQ
- RabbitMQ 发展较早,RocketMQ 是新生的消息类的消息队列
- 从功能、集群化、稳定性、性能来看,RocketMQ 都优于 RabbitMQ - RocketMQ 替代 RabbitMQ
- 国内 - RocketMQ;国外 - RabbitMQ
Kafka
流消息 - 大流量、高吞吐
- Kafka 属于流场景的 MQ - 高吞吐、大流量
- 功能简单 - 不支持死信队列、延时消息等功能
- 非常稳定 + 吞吐性能非常高,能承担超大流量的业务场景 - 流场景下的消息管道的不二之选
Pulsar
- Pulsar 定位 - 消息和流融合
- 目标 - 满足所有消息和流的场景,同时满足功能和性能两方面的需求
- 发展时间较短,不太稳定,处于快速发展阶段
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2019-06-25
Kafka -- 分布式流处理平台
历史消息引擎系统 Kafka在刚诞生时是以消息引擎系统的面目出现在大众视野中 Kafka在0.10.0.0之前的定位:分布式、分区化且带备份功能的提交日志(Commit Log)服务 Kafka在设计之初的功能特性 提供一套API实现生产者和消费者 降低网络传输和磁盘存储开销 实现高伸缩架构 分布式流处理平台 Kafka于2011年正式进入Apache基金会孵化并于次年10月成为Apache顶级项目 Kafka社区于0.10.0.0版本正式推出流处理组件Kafka Streams,定位变成了分布式流处理平台 同等级的实时流处理平台:Apache Kafka、Apache Storm、Apache Spark、Apache Flink 目前国内对Kafka是流处理平台的认知还不普及,其核心的流处理组件Kafka Streams更是少有大厂在使用 优势端到端的正确性 Kafka更容易实现端到端的正确性(Correctness) 流处理要替代批处理需要具备两个核心优势 实现正确性(正确性是流处理能够匹敌批处理的基石) 提供能够推导时间的工具 正确性一直都是批处理的强项,而实现正确性的基石是要求...
2019-09-10
Kafka -- Java消费者管理TCP连接
创建TCP连接 消费者端的主要程序入口是KafkaConsumer,但构建KafkaConsumer实例不会创建任何TCP连接 构建KafkaProducer实例时,会在后台默默地启动一个Sender线程,Sender线程负责Socket连接的创建 在Java构造函数中启动线程,会造成this指针逃逸,是一个隐患 消费者的TCP连接是在调用**KafkaConsumer.poll**方法时被创建的,poll方法内部有3个时机可以创建TCP连接 发起FindCoordinator请求时 消费者组有个组件叫作协调者(Coordinator) 驻留在Broker端的内存中,负责消费者组的组成员管理和各个消费者的位移提交管理 当消费者程序首次启动调用poll方法时,需要向Kafka集群(集群中的任意Broker)发送FindCoordinator请求 社区优化:消费者程序会向集群中当前负载最小的那台Broker发送请求 单向负载评估(非最优解):消费者连接的所有Broker中,谁的待发送请求最少,谁的负载就越小 连接Coordinator时 Broker处理完FindCoordinator请...
2019-09-26
Kafka -- 重设消费者组位移
背景 Kafka和传统的消息引擎在设计上有很大的区别,Kafka消费者读取消息是可以重演的 像RabbitMQ和ActiveMQ等传统消息中间件,处理和响应消息的方式是破坏性 一旦消息被成功处理,就会从Broker上被删除 Kafka是基于日志结构(Log-based)的消息引擎 消费者在消费消息时,仅仅是从磁盘文件中读取数据而已,是只读操作,因为消费者不会删除消息数据 同时,由于位移数据是由消费者控制的,因此能够很容易地修改位移值,实现重复消费历史数据的功能 Kafka Or 传统消息中间件 传统消息中间件:消息处理逻辑非常复杂,处理代价高、又不关心消息之间的顺序 Kafka:需要较高的吞吐量、但每条消息的处理时间很短,又关心消息的顺序 重设位移策略 位移维度 直接把消费者的位移值重设成给定的位移值 时间维度 给定一个时间,让消费者把位移调整成大于该时间的最小位移 维度 策略 含义 位移维度 Earliest 把位移调整到当前最早位移处 Latest 把位移调整到当前最新位移处 Current 把位移调整到当前最新提交位移处 Specified...
2019-09-28
Kafka -- KafkaAdminClient
背景 命令行脚本只能运行在控制台上,在应用程序、运维框架或者监控平台中集成它们,会非常困难 很多命令行脚本都是通过连接ZK来提供服务的,这会存在潜在的问题,即绕过Kafka的安全设置 运行这些命令行脚本需要使用Kafka内部的类实现,也就是Kafka服务端的代码 社区是希望用户使用Kafka客户端代码,通过现有的请求机制来运维管理集群 基于上述原因,社区于0.11版本正式推出Java客户端版的KafkaAdminClient 功能 主题管理 主题的创建、删除、查询 权限管理 具体权限的配置和删除 配置参数管理 Kafka各种资源(Broker、主题、用户、Client-Id等)的参数设置、查询 副本日志管理 副本底层日志路径的变更和详情查询 分区管理 创建额外的主题分区 消息删除 删除指定位移之前的分区消息 Delegation Token管理 Delegation Token的创建、更新、过期、查询 消费者组管理 消费者组的查询、位移查询和删除 Preferred领导者选举 推选指定主题分区的Preferred Broker为领导者 工作原理 Kaf...
2019-09-30
Kafka -- 调优
调优目标 主要目标:高吞吐量、低延时 吞吐量 即TPS,指的是Broker端进程或Client端应用程序每秒能处理的字节数或消息数 延时,可以有两种理解 从Producer发送消息到Broker持久化完成之间的时间间隔 端到端的延时,即从Producer发送消息到Consumer成功消费该消息的总时长 优化漏斗优化漏斗是调优过程中的分层漏斗,层级越靠上,调优的效果越明显 操作系统层 mount -o noatime 在挂载文件系统时禁用atime(Access Time)更新,记录的是文件最后被访问的时间 记录atime需要操作系统访问inode资源,禁用atime可以避免inode访问时间的写入操作 文件系统选择ext4、XFS、ZFS 将swappiness设置成一个很小的值(1~10,默认是60),防止Linux的OOM Killer开启随机杀掉进程 swappiness=0,并不会禁止对swap的使用,只是最大限度地降低使用swap的可能性 因为一旦设置为0,当物理内存耗尽时,操作系统会触发OOM Killer OOM Killer会随机挑选一个进程然后kill掉,不...
2019-09-03
Kafka -- 提交位移
消费位移 Consumer的消费位移,记录了Consumer要消费的下一条消息的位移 假设一个分区中有10条消息,位移分别为0到9 某个Consumer消费了5条消息,实际消费了位移0到4的5条消息,此时Consumer的位移为5,指向下一条消息的位移 Consumer需要向Kafka汇报自己的位移数据,这个汇报过程就是提交位移 Consumer能够同时消费多个分区的数据,所以位移的提交实际上是在分区粒度上进行的 Consumer需要为分配给它的每个分区提交各自的位移数据 提交位移主要是为了表征Consumer的消费进度 当Consumer发生故障重启后,能够从Kafka中读取之前提交的位移值,然后从相应的位移处继续消费 位移提交的语义 如果提交了位移X,那么Kafka会认为位移值小于X的消息都已经被成功消费了 灵活 位移提交非常灵活,可以提交任何位移值,但要承担相应的后果 假设Consumer消费了位移为0~9的10条消息 如果提交的位移为20,位移位于10~19的消息可能会丢失 如果提交的位移为5,位移位于5~9的消息可能会被重复消费 位移提交的语义保障由应用程序保证,Ka...