RAG - In Action
技术选型
LangChain
- LangChain 是专门为开发基于 LLM 应用而设计的全面框架
- LangChain 的核心目标是简化开发者的构建流程,使其能够高效地创建 LLM 驱动的应用
索引
文档解析
- pypdf 专门用于处理 PDF 文档
- pypdf 支持 PDF 文档的创建、读取、编辑和转换,能够有效地提取和处理文本、图像及页面内容
文档分块
- RecursiveCharacterTextSplitter 是 LangChain 默认的文本分割器
- RecursiveCharacterTextSplitter 通过层次化的分隔符(从双换行符到单字符)拆分文本
- 旨在保持文本的结构和连贯性,优先考虑自然边界(如段落和句子)
索引 + 检索
向量化模型
- bge-small-zh-v1.5 是由北京智源人工智能研究院(BAAI)开发的开源向量模型
- bge-small-zh-v1.5 的模型体积较小,但仍能提供高精度和高效的中文向量检索
- bge-small-zh-v1.5 的向量维度为 512,最大输入长度同样为 512
向量库
- Faiss - Facebook AI Similarity Search
- Faiss 由 Facebook AI Research 开源的向量库,非常稳定和高效
生成
LLM
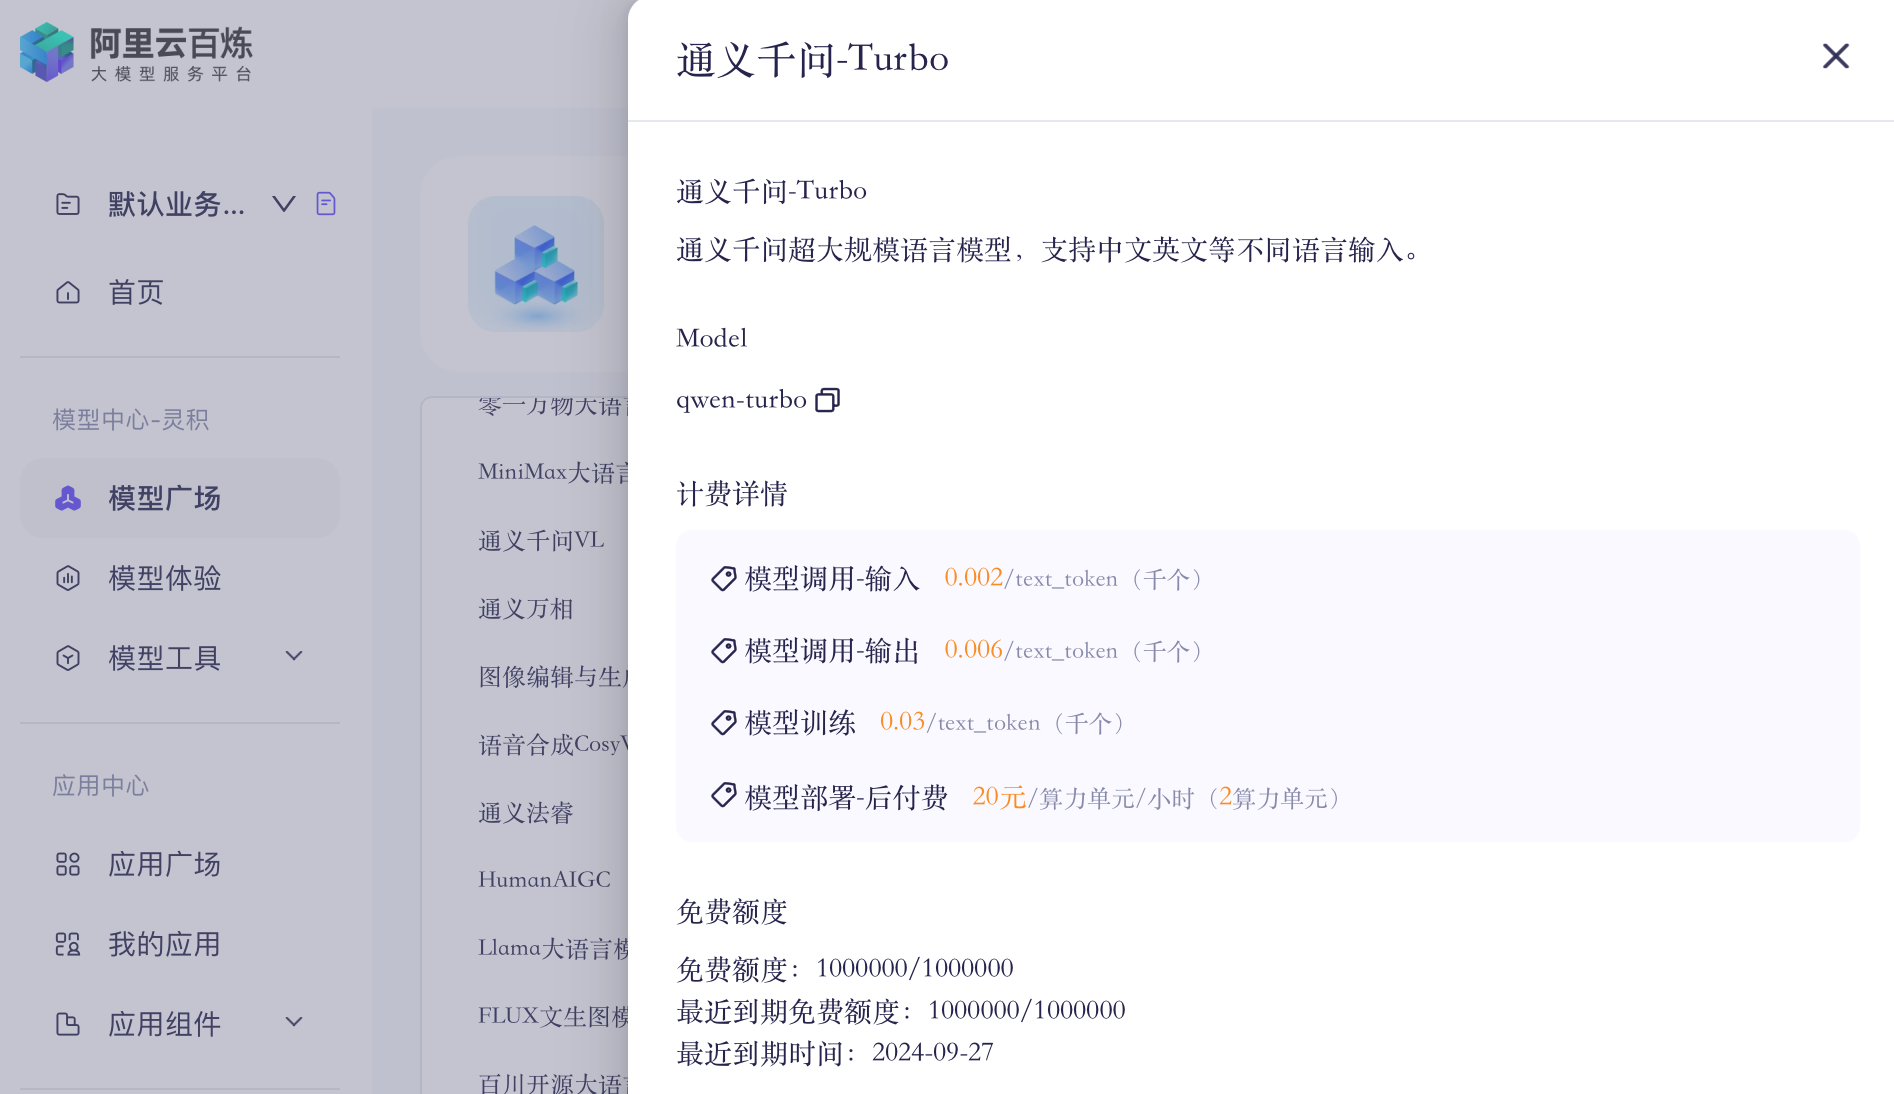
- Qwen 是阿里云推出的一款超大规模语言模型
- Qwen 支持多轮对话、文案创造、逻辑推理、多模态理解和语言处理
- Qwen 在模型性能和工程应用中表现出色
- Qwen 支持云端 API 服务
RAG

- LangChain
- 提供用于构建 LLM RAG 的应用程序框架
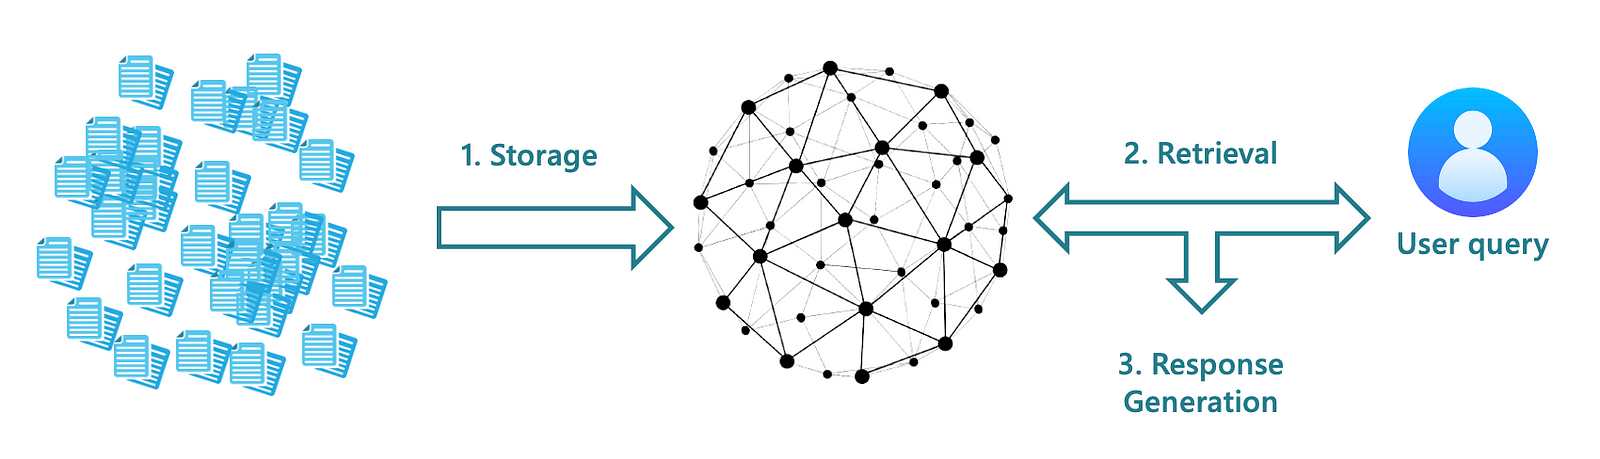
- 索引流程
- 使用 pypdf 对文档进行解析并提取信息
- 采用 RecursiveCharacterTextSplitter 对文档内容进行分块(Chunk)
- 使用 bge-small-zh-v1.5 将 Chunk 进行向量化处理,并将生成的向量存储到 Faiss 向量库中
- 检索流程
- 使用 bge-small-zh-v1.5 对 Query 进行向量化处理
- 通过 Faiss 向量库对 Query 向量和 Chunk 向量进行相似度匹配
- 从而检索出与 Query 最相似的 Top K 个 Chunk
- 生成流程
- 设定提示模板(Prompt)
- 将 Query 与 Chunk 填充到提示模板,生成增强提示,输入到 Qwen LLM,生成最终的 RAG 回答
开发环境
虚拟环境
1 | $ python3 -m venv rag_env |
安装依赖
1 | $ pip install --upgrade pip |
向量化模型
bge-small-zh-v1.5 - 95.8MB - pytorch_model.bin
1 | $ git clone https://huggingface.co/BAAI/bge-small-zh-v1.5 |
核心代码
依赖
1 | from langchain_community.document_loaders import PyPDFLoader # PDF文档提取 |
索引
Embedding
SentenceTransformer - map sentences / text to embeddings
1 | def load_embedding_model(): |
Indexing
chunk_size + chunk_overlap
- chunk_size
- 对输入文本序列进行切分的最大长度
- GPT-3 的最大输入长度为 2048 个 Token
- chunk_overlap
- 相邻的两个 Chunk 之间的重叠 Token 数量
- 为了保证文本语义的连贯性,相邻 Chunk 会有一定的重叠
- chunk_size = 1024,chunk_overlap = 128,对于长度为 2560 Token 的文本序列,会切分成 3 个 Chunk
- 1 ~ 1024 = 1024
- 897~1920 = 1024
- 1793~2560 = 768
索引
1 | def indexing_process(pdf_file, embedding_model): |
- 使用 PyPDFLoader 加载并预处理 PDF 文档,将其内容提取并合并为完整文本
- 利用 RecursiveCharacterTextSplitter 将文本分割为每块 512 字符(非 Token)、重叠 128 字符(非 Token)的文本块
- 通过预加载的 bge-small-zh-v1.5 嵌入模型将文本块转化为归一化的嵌入向量
- 将嵌入向量存储在基于余弦相似度的 Faiss 向量库中,以支持后续的相似性检索和生成任务
余弦相似度 - Cosine Similarity - 在 N 维空间中,两个 N 维向量之间角度的余弦 - 值越大越相似
$$
Similarity(A,B) = \frac{A\cdot{B}}{|A|\times|B|} = \frac{\sum_{i=1}^n(A_i\times{B_i})}{\sqrt{\sum_{i=1}^n{A_i^2}}\times\sqrt{\sum_{i=1}^n{B_i^2}}}
$$
待优化项
- 多文档处理
- 嵌入模型的效率优化与并行处理
- Faiss 采用持久化存储 - 目前仅在内存中存储
检索
1 | def retrieval_process(query, index, chunks, embedding_model, top_k=3): |
- Query 被预加载的 bge-small-zh-v1.5 嵌入模型转化为归一化的嵌入向量
- 进一步转换为 numpy 数组以适配 Faiss 向量库的输入格式
- 利用 Faiss 向量库中的向量检索功能
- 计算 Query 与存储向量之间余弦相似度,从而筛选出与 Query 最相似的 Top K 个文本块
- 相似文本块存储在结果列表中,供后续生成过程使用
生成
1 | def generate_process(query, chunks): |
- 结合 Query 与检索到的文本块组织成 LLM Prompt
- 调用 Qwen 云端 API,将 Prompt 发送给 LLM
- 利用流式输出的方式逐步获取 LLM 生成的响应内容,实时输出并汇总成最终的生成结果
输出
1 | 生成过程开始: |
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-08-11
RAG - KG-RAG
Knowledge Graph 知识图谱也称为语义网络,表示现实世界实体的网络,并说明它们之间的关系 信息通常存储在图形数据库中,并以图形结构直观呈现 知识图谱由三部分组成 - 节点 + 边 + 标签 Why 降噪 + 提召 + 提准 传统 RAG 中的 Chunking 方式会召回一些噪音的 Chunk 引入 KG,可以通过实体层级特征来增强相关性 传统 RAG 中的 Chunk 之间是彼此孤立的,缺乏关联,在跨文档回答任务上表现不太好 引入 KG,增强 Chunk 之间的关联,并提升召回的相关性 假设已有 KG 数据存在,可以将 KG 作为一路召回信息源,补充上下文信息 Chunk 之间形成的 KG,可以提供 Graph 视角的 Embedding,来补充召回特征 构建一个高质量、灵活更新、计算简单的大规模图谱的代价很高 - RAG 会很慢 https://hub.baai.ac.cn/view/30017 https://hub.baai.ac.cn/view/33147 https://hub.baai.ac.cn/view/33390 https://hub.baa...
2024-08-16
RAG - Evolution
演进 Naive RAG -> Advanced RAG -> Modular RAG 三个范式之间具有继承与发展的关系 Advanced RAG 是 Modular RAG 的一种特例形式 Naive RAG 是 Advanced RAG 的基础特例 RAG 技术不断演进,以适应更复杂的任务和场景需求 Naive RAG Naive RAG 是最基础的形式,依赖核心的索引和检索策略来增强生成模型的输出 Naive RAG 适用于一些基础任务和产品 MVP 阶段 Advanced RAG 通过增加检索前、检索中以及检索后的优化策略,提高检索的准确性和生成的关联性 - 适用于复杂任务 Advanced RAG 通过优化检索前、检索中、检索后的各个环节 在索引质量、检索效果以及生成内容的上下文相关性方面都取得显著提升 检索前 通过索引、分块、查询优化和内容向量化等技术手段,提高检索内容的精确性和生成内容的相关性 滑动窗口 overlap 经典的 Chunking 技术,通过在相邻的 Chunk 之间创建重叠区域,确保关键信息不会因简单的 Chunking 而丢失 在 ...
2024-06-27
LLM - LangChain + RAG
局限 大模型的核心能力 - 意图理解 + 文本生成 局限 描述 数据的及时性 大部分 AI 大模型都是预训练的,如果要问一些最新的消息,大模型是不知道的 复杂任务处理 AI 大模型在问答方面表现出色,但不总是能够处理复杂任务AI 大模型主要是基于文本的交互(多模态除外) 代码生成与下载 根据需求描述生成对应的代码,并提供下载链接 - 暂时不支持 与企业应用场景的集成 读取关系型数据库里面的数据,并根据提示进行任务处理 - 暂时不支持 在实际应用过程中,输入数据和输出数据,不仅仅是纯文本 AI Agent - 需要解析用户的输入输出 AI Agent AI Agent 是以 LLM 为核心控制器的一套代理系统 控制端处于核心地位,承担记忆、思考以及决策等基础工作 感知模块负责接收和处理来自于外部环境的多样化信息 - 文字、声音、图片、位置等 行动模块通过生成文本、API 调用、使用工具等方式来执行任务以及改变环境 LangChain - 开源 + 提供一整套围绕 LLM 的 Agent 工具 AI Agent 很有可能在未来一段时间内成为 AI 发展的一...
2024-06-29
LLM PEFT - ChatGLM3-6B + LoRA
通用 LLM 千亿大模型(130B、ChatGPT)和小规模的大模型(6B、LLaMA2)都是通用 LLM 通用 LLM 都是通过常识进行预训练的 在实际使用过程中,需要 LLM 具备某一特定领域知识的能力 - 对 LLM 的能力进行增强 增强方式 Method Desc 微调 让预先训练好的 LLM 适应特定任务或数据集的方案,成本相对低LLM 学会训练者提供的微调数据,并具备一定的理解能力 知识库 使用向量数据库或者其它数据库存储数据,为 LLM 提供信息来源外挂 API 与知识库类似,为 LLM 提供信息来源外挂 互不冲突,可以同时使用几种方案来优化 LLM,提升内容输出能力 LoRA / QLoRA / 知识库 / API LLM Performance = 推理效果 落地过程 Method Pipeline 微调 准备数据 -> 微调 -> 验证 -> 提供服务 知识库 准备数据 -> 构建向量库 -> 构建智能体 -> 提供服务 API 准备数据 -&g...
2024-08-01
RAG - AI 2.0
AI 技术 做 AI 产品的工程研发需充分掌握 AI 技术 AI 产品从 MVP 到 PMF 的演进过程中会面临非常多的挑战 MVP - Minimum Viable Product - 最小可用产品 PMF - Product-Market Fit - 产品市场契合 要实现 AI 产品的 PMF 首先需要充分了解 AI 技术,明确技术边界,找到合适 AI 技术的应用场景 其次,需要深刻理解业务,用户需求决定产品方向,AI 技术是为业务服务的工具 在验证阶段,优先使用最佳 AI 模型以确保产品满足市场需求,确认后再逐步降低模型成本 坚持业务优先、价值至上的原则,避免纯 AI 科研化,脱离实际场景做 AI 技术选型 RAG LLM 局限 - 幻觉 + 知识实效性 + 领域知识不足 + 数据安全问题 由 OpenAI ChatGPT 引领的 AI 2.0 LLM 时代,见证了 LLM 在知识、逻辑、推理能力上的突破 Scaling Law、压缩产生智能、边际成本为零为理想中的 AGI 尽管 LLM 功能强大,但仍存在幻觉、知识实效性、领域知识不足以及数据安全问题的局限性 - RAG 文档问...
2024-06-28
LLM Deploy - ChatGLM3-6B
LLM 选择核心玩家 厂家很多,但没多少真正在研究技术 - 成本 - 不少厂商是基于 LLaMA 套壳 ChatGLM-6B ChatGLM-6B 和 LLaMA2 是比较热门的开源项目,国产 LLM 是首选 企业布局 LLM 选择 MaaS 服务,调用大厂 LLM API,但会面临数据安全问题 选择开源 LLM,自己微调、部署、为上层应用提供服务 企业一般会选择私有化部署 + 公有云 MaaS 的混合架构 在国产厂商中,从技术角度来看,智谱 AI 是国内 LLM 研发水平最高的厂商 6B 的参数规模为 62 亿,单张 3090 显卡就可以进行微调和推理 企业预算充足(百万以上,GPU 费用 + 商业授权) 可以尝试 GLM-130B,千亿参数规模,推理能力更强 GLM-130B 轻量化后,可以在 3090 × 4 上进行推理 训练 GLM-130B 大概需要 96 台 A100(320G),历时两个多月 计算资源 适合 CPU 计算的 LLM 不多 有些 LLM 可以在 CPU 上进行推理,但需要使用低精度轻量化的 LLM 但在低精度下,LLM 会失真,效果较差 要真正体验并应...