Big Data - CAP
CAP
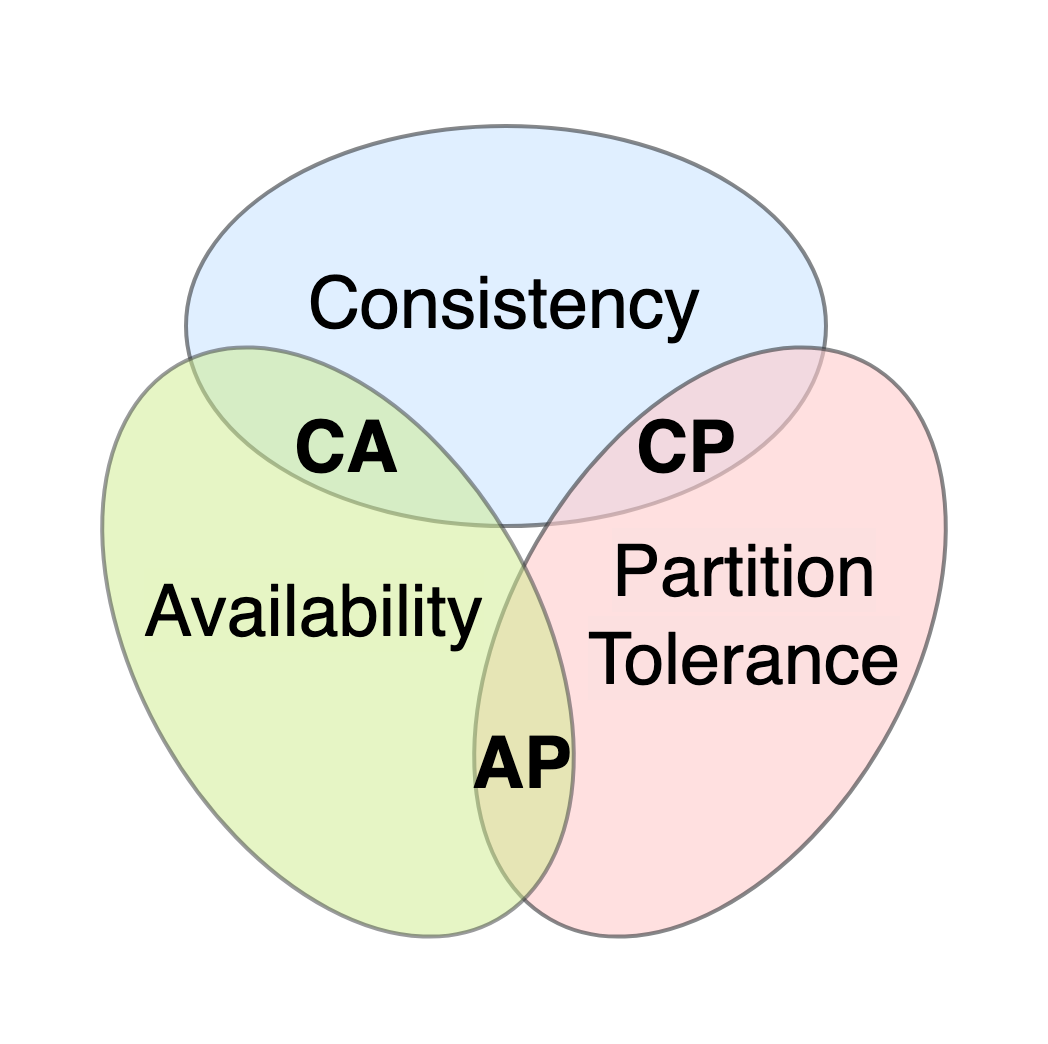
在任意的分布式系统中,最多只能同时满足两个:Consistency、Availability、Partition-tolerance
Consistency
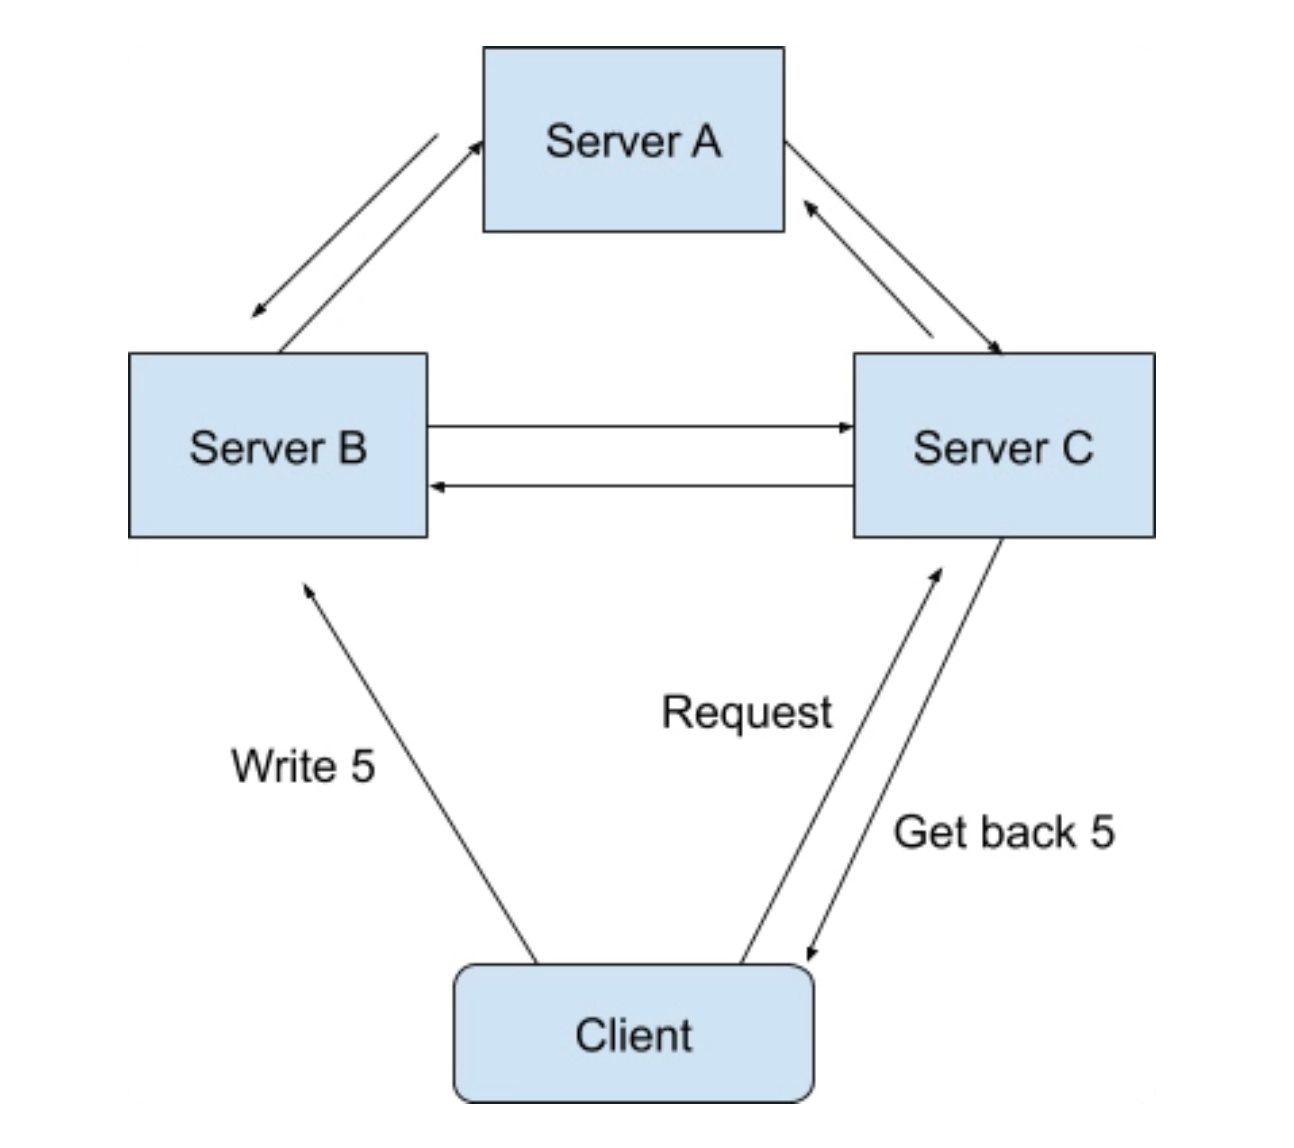
- Consistency 指的是 Linearizability Consistency
- 在 Linearizability Consistency 的保证下,所有分布式环境下的操作都像在单机上一样
- 所有节点的状态一直是一致的
Availability
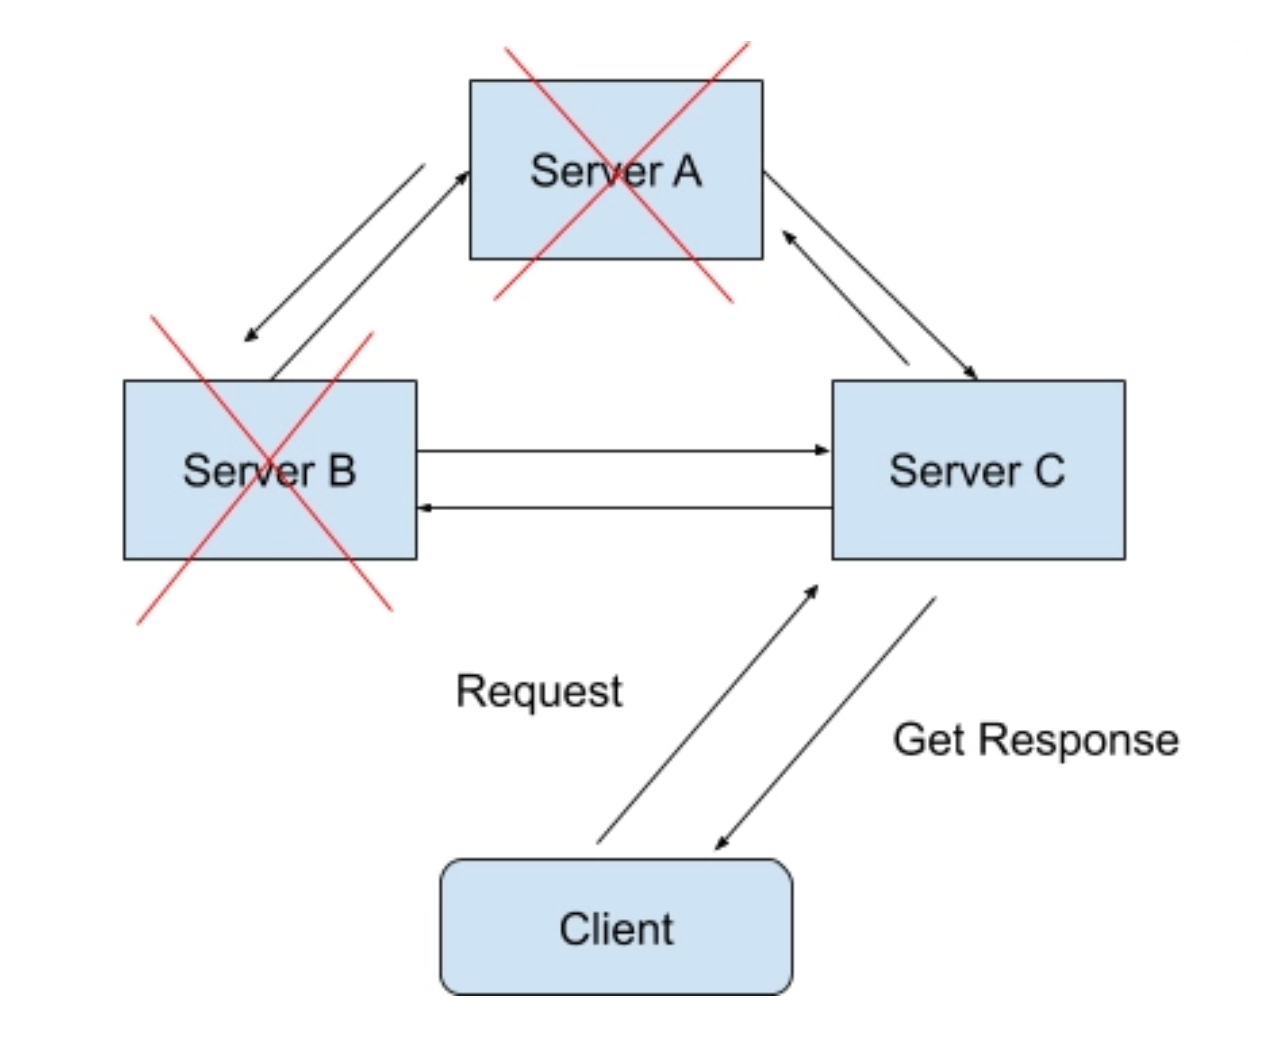
- 在分布式系统中,任意非故障的节点都必须对客户的请求产生响应
- 当系统满足 Availability 时,除非所有节点全部崩溃,不然都能返回消息 - Netflix Eureka
Partition Tolerance
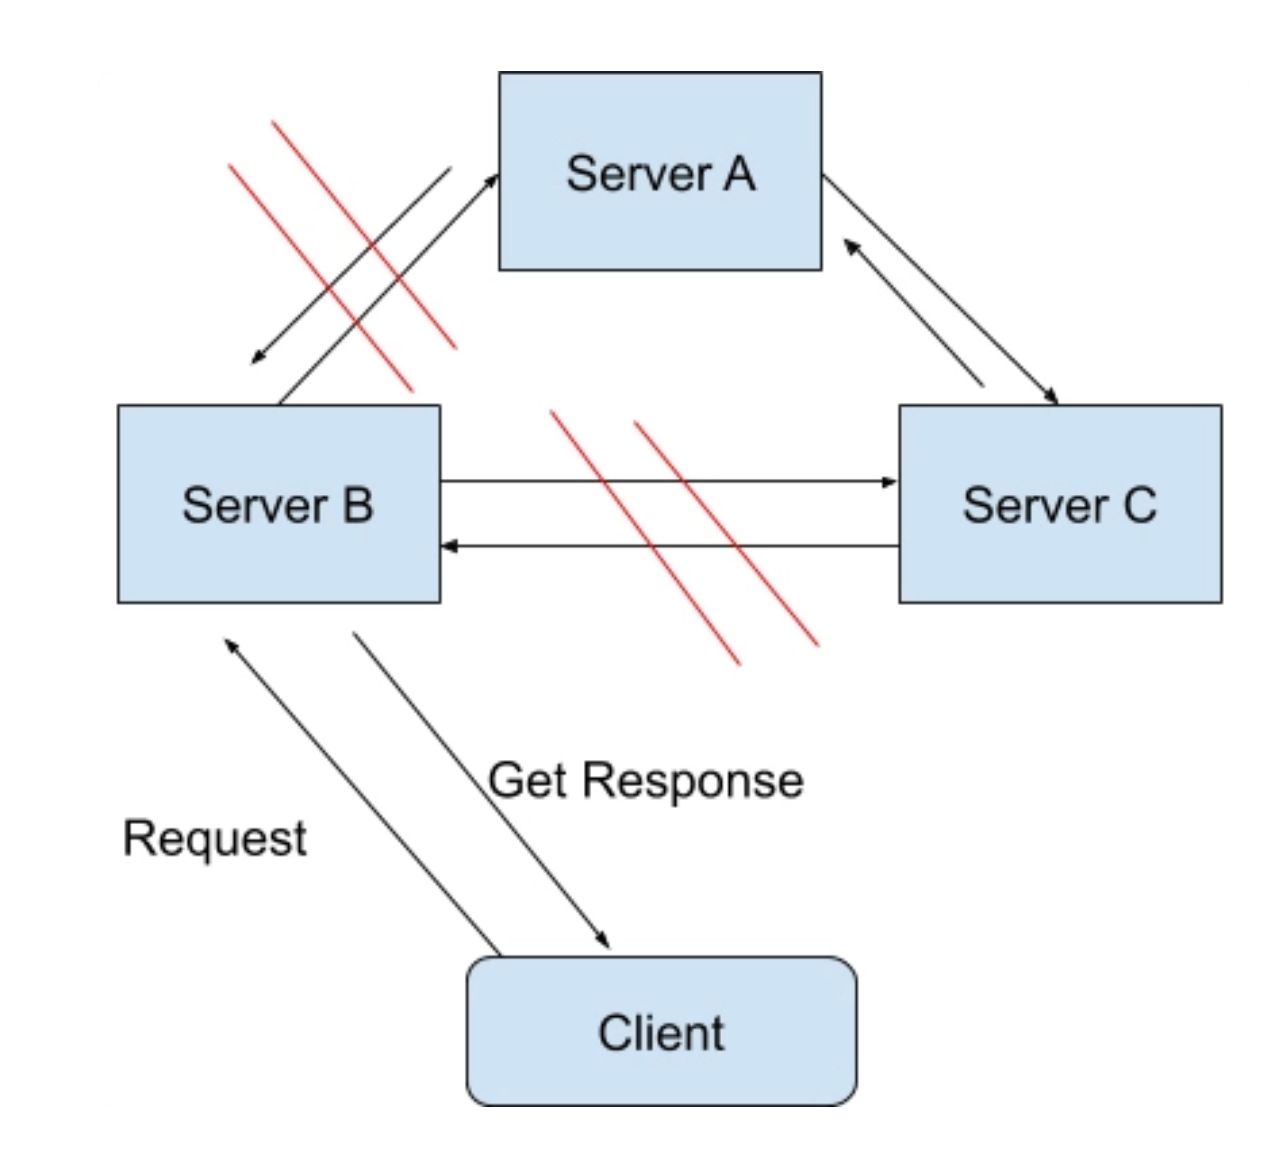
- 在一个分布式系统中,如果出现了一些故障,可能会使得部分节点之间无法连通
- 由于故障节点无法连通,造成整个网络会被分成几块区域
- 从而使数据分散在这些无法连通的区域中的情况,从而发生了分区错误
- 如上图,如果需要的数据只在 Sever A 中,当出现分区错误时,无法获取到数据
- 如果能分区容错,既即便出现这种情况,分布式系统也能容忍,并能返回消息
- Partition-tolerance
- 分布式系统允许网络丢失从一个节点发送到另一个节点的任意多条消息
- 在现代网络通信中,节点故障或者网络丢包会经常发生
- 如果没有 Partition-tolerance,即分布式系统不允许这些节点间的通信出现任何错误
- 如果不接受 Partition-tolerance,很多系统都无法正常工作了
Netflix Eureka 为 AP 系统,并支持最终一致性,并非论文中的线性一致性
AP vs CP
在大部分情况下,分布式系统的设计都会保留 P,而在 C 和 A 中二选一
| Type | Distributed system |
|---|---|
| CP | Google BigTable、Hbase、MongoDB、Redis、MemCacheDB |
| AP | Amazon Dynamo、Apache Cassandra、Netflix Eureka |
| CA | Apache Kafka |
Kafka Replication
CA
- Kafka Replication 通过将数据复制到不同的节点上,从而增强了数据在系统中的持久性(Durability)和可用性(Availability)
- 在 Kafka Replication 的系统设计中,所有的数据日志存储是在同一个数据中心中 - 在同一个数据中心出现网络分区的概率非常低
架构设计
- 先通过 Zookeeper 选举出一个 Leader
- 该 Leader 负责维护一组被称为同步数据副本(In-sync-replica)的节点,所有的数据写入都必须在这个 Leader 中记录 - ZAB 协议
三台服务 - Leader + Replication1 + Replication2
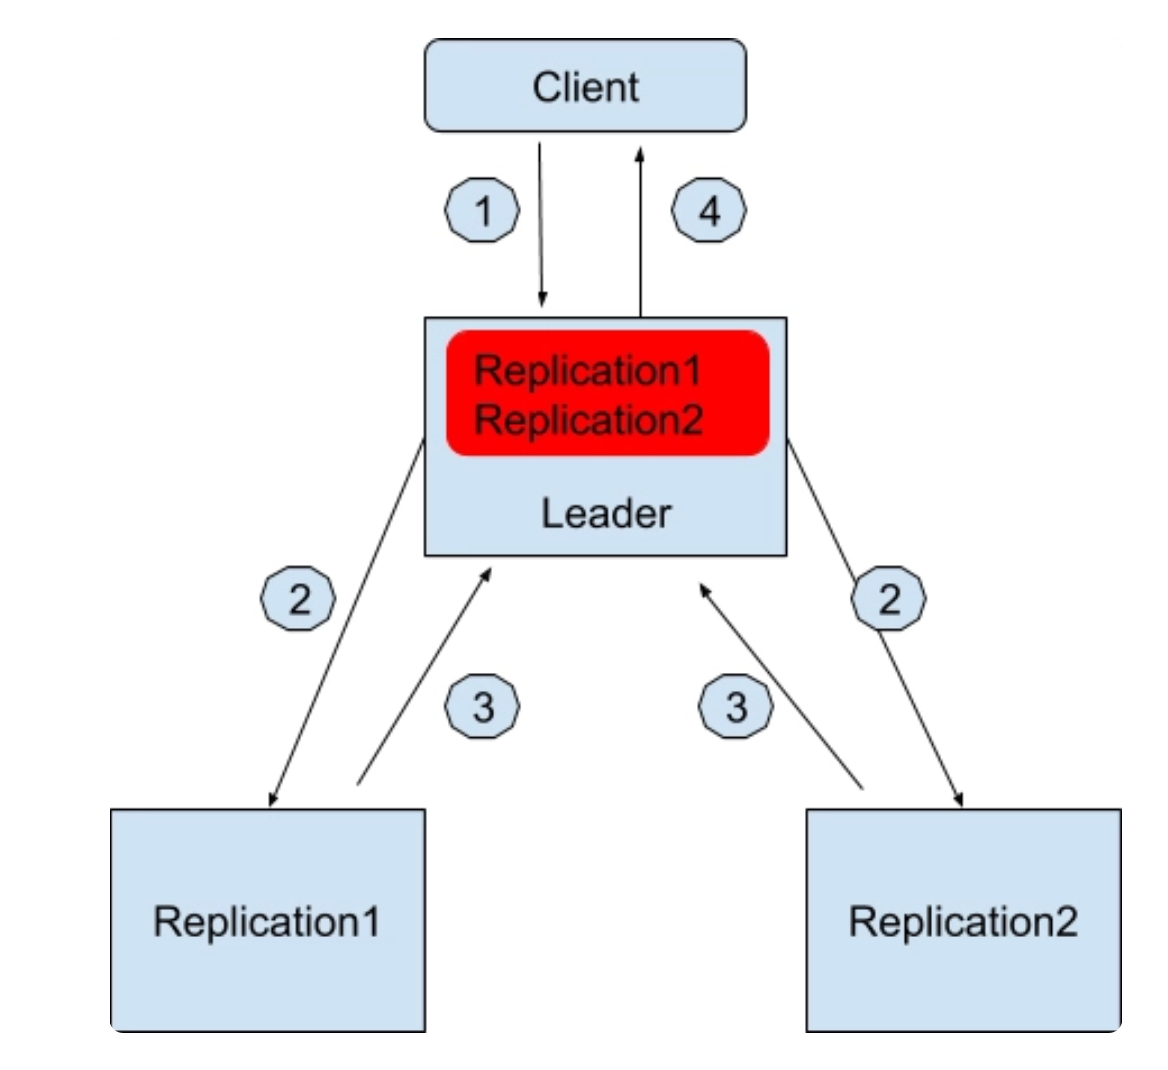
出现网络分区 - Leader 与 Replication1 无法通讯
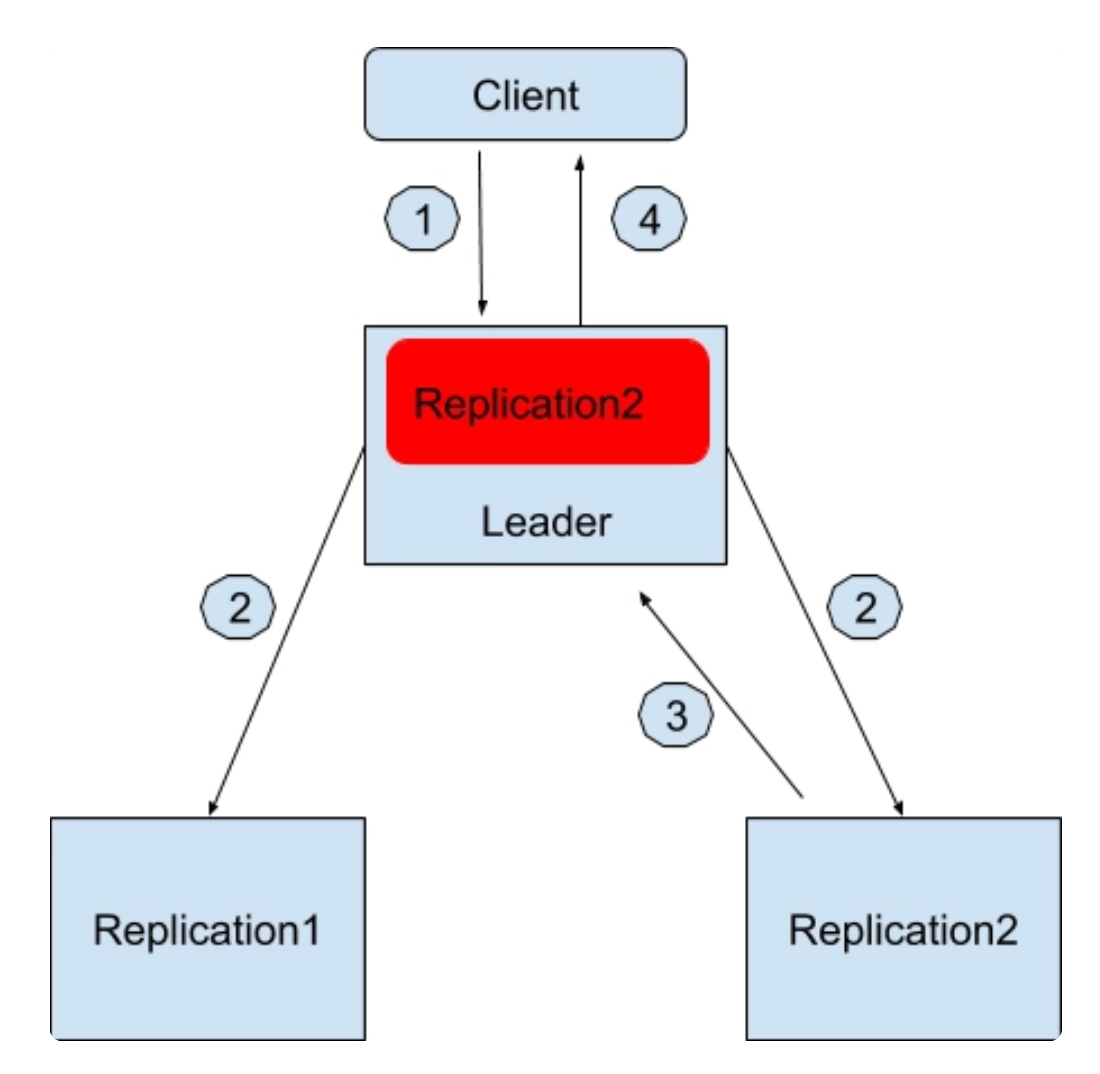
所有副本都无法通讯,Apache Kafka 允许只有 Leader 在工作
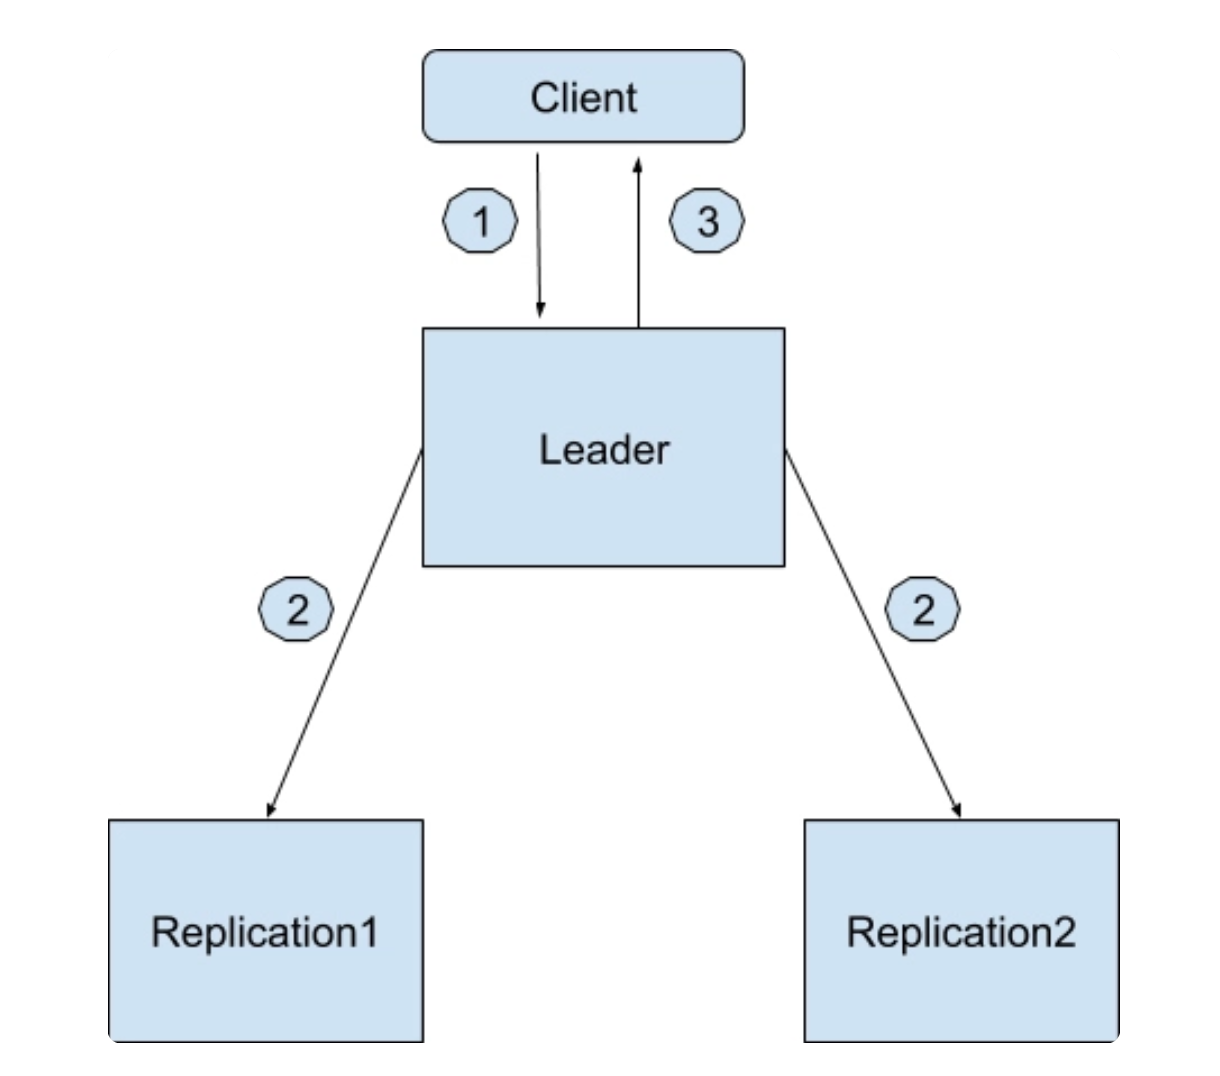
如果 Leader 挂了,则 Zookeeper 会重新选举
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-09-24
Beam - Paradigm
Why Apache Beam 本身并不是一个数据处理平台,本身也无法对数据进行处理 Apache Beam 所提供的是一个统一的编程模型思想 通过 Apache Beam 统一的 API 来编写处理逻辑,该处理逻辑会被转化为底层运行引擎相应的 API 去运行 SDK 会变,但背后的设计原理却不会改变 生态 Layer Desc Runner 现有的各种大数据处理平台,如 Apache Spark、Apache Flink 可移植的统一模型层 各个 Runner 将会依据中间抽象出来的模型思想Runner 将提供一套符合该模型的 APIs 出来,以供上层转换 SDK 提供不同语言版本的 API 来编写数据处理逻辑这些数据处理逻辑会被转换成 Runner 中相应的 API 来运行 基本概念 数据可以分成有界数据和无界数据 其中有界数据是无界数据的特例,可以将所有的数据抽象看作无界数据 每个数据都有两个时域,即事件时间和处理时间 处理无界数据时,数据会有延迟、丢失的情况 因此,无法保证是否接收完了所有发生在某一时刻之前的数据 - 事件时间 流处理必须在数据的完整性和数据...
2024-10-04
Beam - Streaming
有界数据 vs 无界数据 在 Beam 中,可以用同一个 Pipeline 处理有界数据和无界数据 无论是有界数据还是无界数据,在 Beam 中,都可以用窗口把数据按时间分割成一些有限大小的集合 对于无界数据,必须使用窗口对数据进行分割,然后对每个窗口内的数据集进行处理 读取无界数据 withLogAppendTime - 使用 Kafka 的 log append time 作为 PCollection 的时间戳 12345678Pipeline pipeline = Pipeline.create();pipeline.apply( KafkaIO.<String, String>read() .withBootstrapServers("broker_1:9092,broker_2:9092") .withTopic("shakespeare") // use withTopics(List<String>) to read from multiple topics. .wi...
2024-10-02
Beam - WordCount
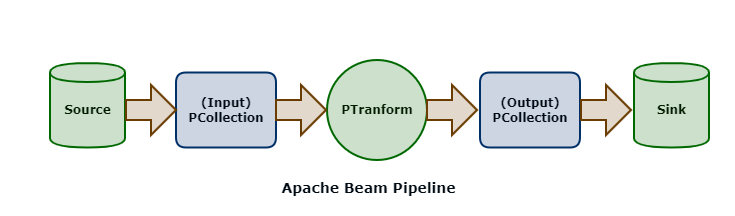
步骤 用 Pipeline IO 读取文本 用 Transform 对文本进行分词和词频统计 用 Pipeline IO 输出结果 将所有步骤打包成一个 Pipeline 创建 Pipeline 默认情况下,将采用 DirectRunner 在本地运行 1PipelineOptions options = PipelineOptionsFactory.create(); 一个 Pipeline 实例会构建数据处理的 DAG,以及这个 DAG 所需要的 Transform 1Pipeline p = Pipeline.create(options); 应用 Transform TextIO.Read - 读取外部文件,生成一个 PCollection,包含所有文本行,每个元素都是文本中的一行 123String filepattern = "file:///Users/zhongmingmao/workspace/java/hello-beam/corpus/shakespeare.txt";PCollection<String> lines = ...
2024-09-25
Beam - PCollection
数据抽象 Spark RDD 不同的技术系统有不同的数据结构, 如在 C++ 中有 vector、unordered_map 几乎所有的 Beam 数据都能表达为 PCollection PCollection - Parallel Collection - 可并行计算的数据集,与 Spark RDD 非常类似 在一个分布式计算系统中,需要为用户隐藏实现细节,包括数据是怎样表达和存储的 数据可能来自于内存的数据,也可能来自于外部文件,或者来自于 MySQL 数据库 如果没有一个统一的数据抽象的话,开发者需要不停地修改代码,无法专注于业务逻辑 Coder 将数据类型进行序列化和反序列化,便于在网络上传输 需要为 PCollection 的元素编写 Coder Coder 的作用与 Beam 的本质紧密相关 计算流程最终会运行在一个分布式系统 所有的数据都可能在网络上的计算机之间相互传递 Coder 就是告诉 Beam 如何将数据类型进行序列化和反序列化,以便于在网络上传输 Coder 需要注册进全局的 CoderRegistry 为自定义的数据类型建立与 Coder 的对应关系,无...
2024-09-18
Spark - RDD
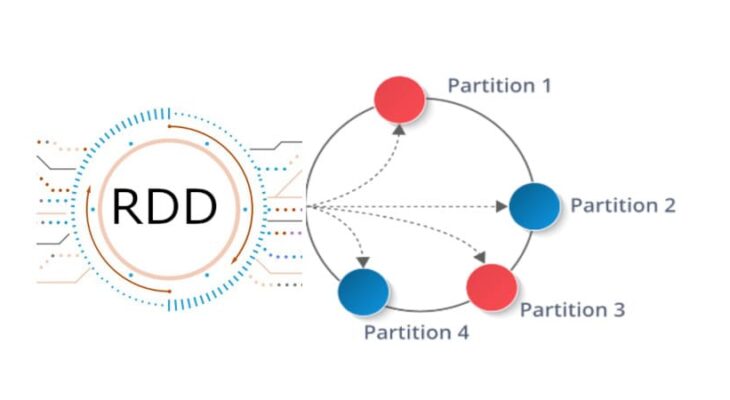
分布式内存 传统的 MapReduce 框架运行缓慢,主要原因是 DAG 的中间计算结果需要写入硬盘来防止运行结果丢失 每次调用中间计算结果都需要进行一次硬盘的读取 反复对硬盘进行读写操作以及潜在的数据复制和序列化操作会大大地提高了计算延迟 新的分布式存储方案 - 保持之前系统的稳定性、错误恢复和可扩展性,并尽可能地减少硬盘 IO 操作 RDD 是基于分布式内存的数据抽象,不仅支持基于工作集的应用,同时具有数据流模型的特点 定义分区 分区代表同一个 RDD 包含的数据被存储在系统的不同节点上,这是可以被并行处理的前提 在逻辑上,可以认为 RDD 是一个大数组,数组中的每个元素代表一个分区(Partition) 在物理存储中,每个分区指向一个存放在内存或者硬盘中的数据块(Block) Block 是独立的,可以被存放在分布式系统中的不同节点 RDD 只是抽象意义的数据集合,分区内部并不会存储具体的数据 RDD 中的每个分区都有它在该 RDD 中的 Index 通过 RDD_ID 和 Partition_Index 可以唯一确定对应 Block 的编号 从而通过底层存储层的接口中提取...
2024-09-11
Big Data - Batch + Stream
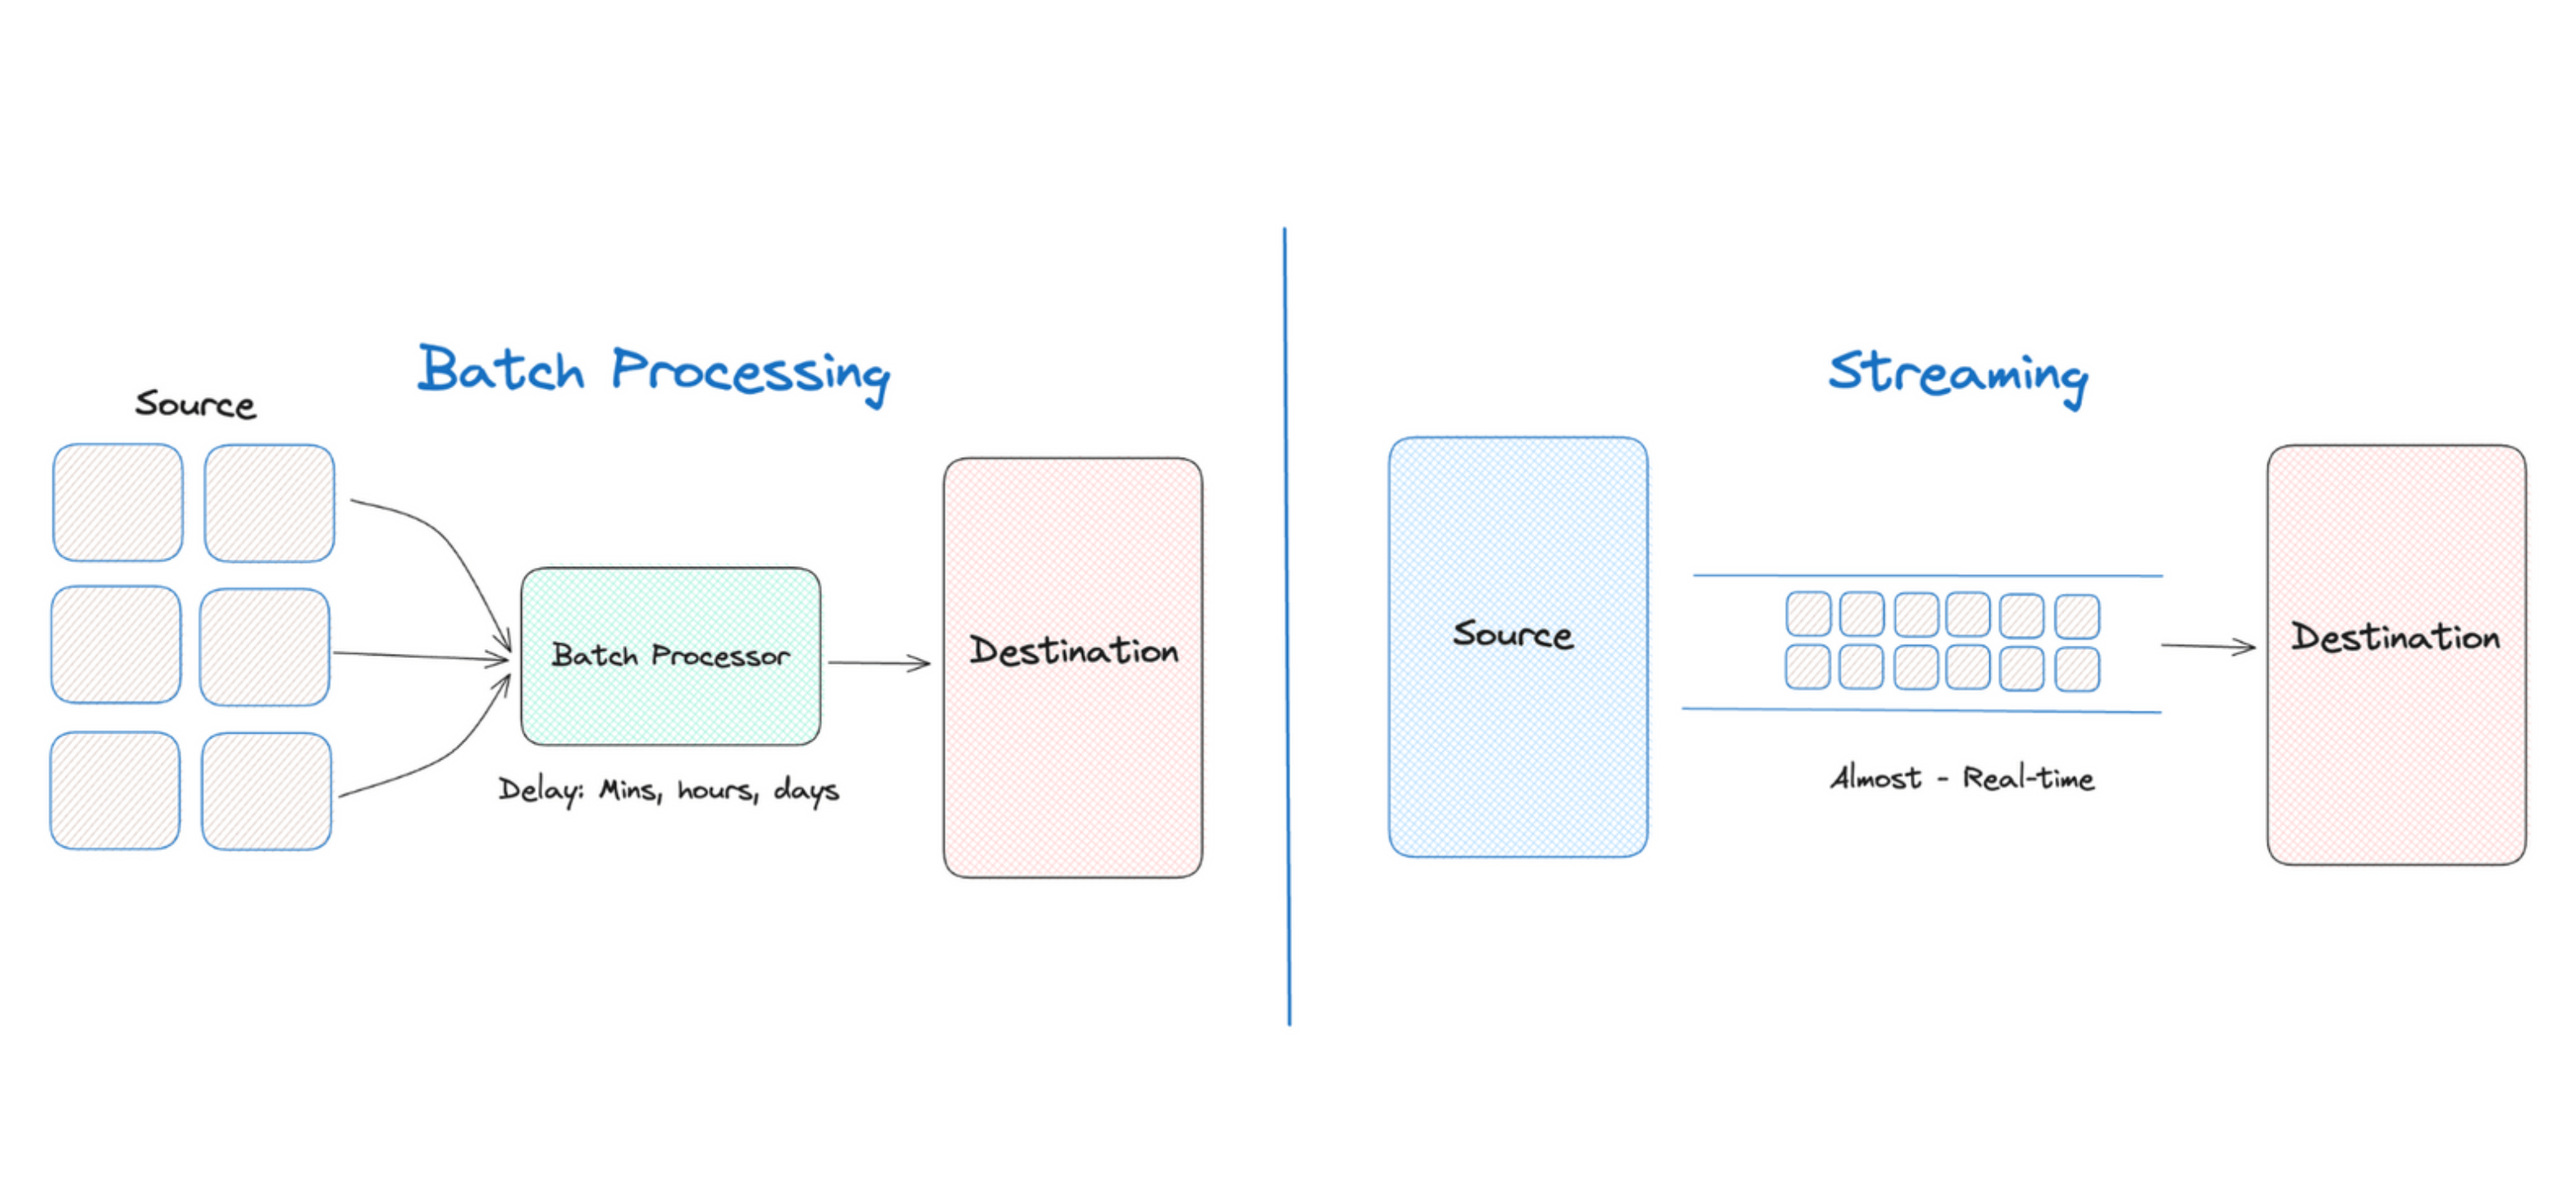
ConceptUnbounded vs Bounded 有界数据是无界数据的一个子集 无界数据是一种不断增长,是无限的数据集,无法判定何时停止发送 - Streaming Data 有界数据是一种有限的数据集 Event Time vs Precessing Time Time Domain Desc 事件时间 - Event Time 一个数据实际产生的时间点 处理时间 - Precessing Time 处理数据的系统架构实际接收到这个数据的时间点 Batching 数据的批处理 - 一系列相关联的任务按顺序(或并行)一个接一个地执行 批处理的输入是在一段时间内已经收集保存好的数据 每次批处理所产生的输出可以作为下一次批处理的输入 - Pipeline 绝大部分情况下,批处理的输入输出都是有界数据,更多关心的数据的事件时间 批处理任务一般会以定时任务的形态存在 应用场景 - 日志分析、计费应用、数据仓库 开源项目 - Apache Hadoop、Apache Spark 缺点 - 高延迟性 Streaming 数据的流处理 - 系统需要接收并处理一系列连续不断变化的数据...