Big Data - Kappa
Lambda
概述
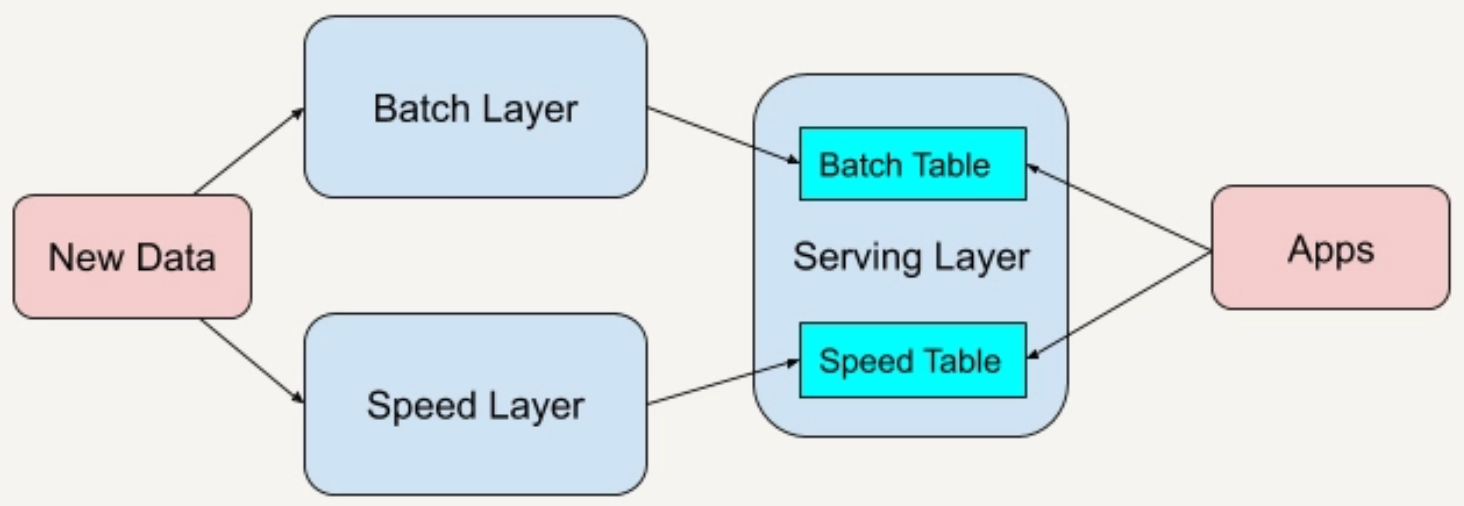
- Lambda 架构结合了批处理和流处理的架构思想
- 将进入系统的大规模数据同时送入两套架构层中,即 Batch Layer 和 Speed Layer
- 同时产生两套数据结果并存入 Serving Layer 中
优点
- Batch Layer 有很好的容错性,同时由于保存着所有的历史记录,使得产生的数据具有很好的准确性
- Speed Layer 可以及时处理流入的数据,具有低延迟性
- 最终 Serving Layer 将两套数据结合,并生成一个完整的数据视图提供给用户
- Lambda 架构也具有很好的灵活性,可以将不同开源组件嵌入到该架构中
不足
- 使用 Lambda 架构,需要维护两个复杂的分布式系统,并保证它们逻辑上产生相同的结果输出到 Serving Layer
- 在分布式框架中进行编程是非常复杂的,尤其需要对不同的框架进行专门的优化 – 高昂的维护成本
- 维护 Lambda 架构的复杂性 – 同时维护两套系统架构
- 方向 - 改进其中一层的架构,让其具有另一层架构的特性
Kappa
架构
Apache Kafka 具有永久保存数据日志的功能,基于该特性,可以让 Speed Layer 重新处理历史数据
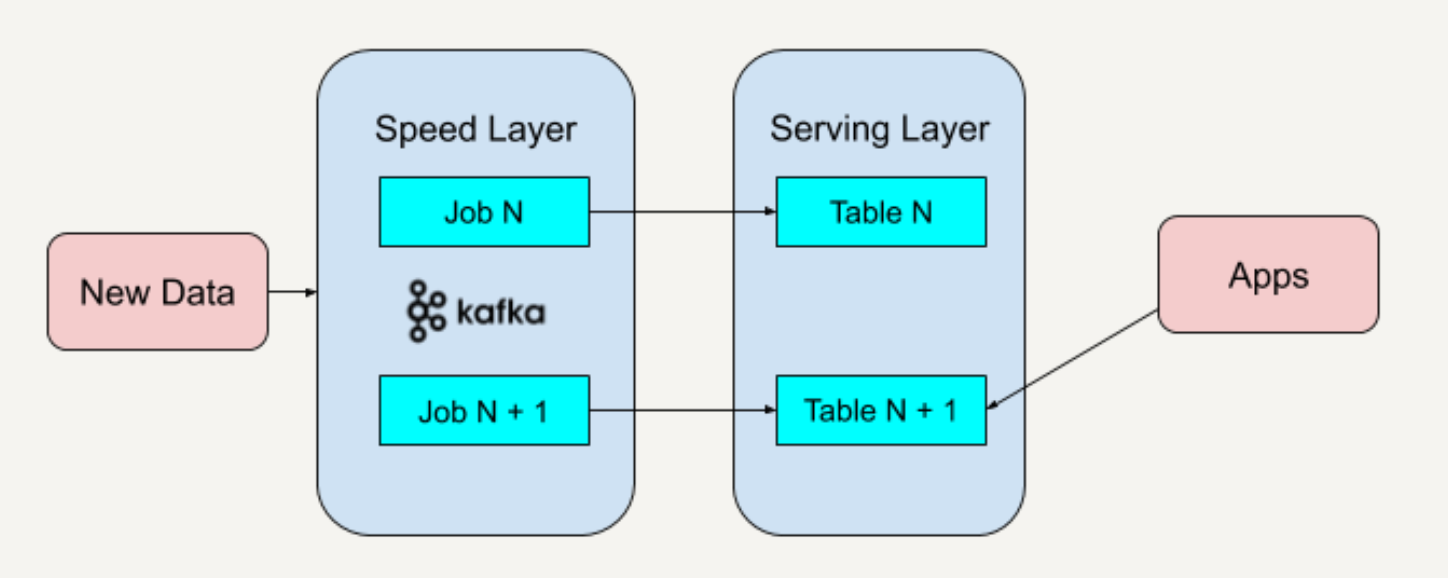
- 部署 Apache Kafka,设置数据日志的保留期 - 希望重新处理的历史数据的时间区间
- 如果需要改进现有的逻辑算法,则表示需要对历史数据进行重新处理
- 将 Apache Kafka 的 Log Offset 重置为 0,重新计算保留好的历史数据,生成一个新的数据视图
- 当新的数据视图处理过的数据进度赶上了旧的数据视图,则可以切换到新的数据视图中进行读取
- 与 Lambda 架构不同的是,Kappa 架构移除了 Batch Layer 的体系结构,只保留了 Speed Layer
- 只需要在业务逻辑改变或者代码更改的时候进行数据的重新处理
不足
- 只保留了 Speed Layer 而缺少 Batch Layer,在 Speed Layer 上处理大规模数据可能会有数据更新出错的情况
- 需要花费更多的时间在异常处理上
- Kappa 架构的批处理和流处理都放在了 Speed Layer 上,使用同一套代码来处理算法逻辑
- 所以,Kappa 架构不适合于批处理和流处理的代码逻辑不一致的场景
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2024-09-26
Beam - Transform
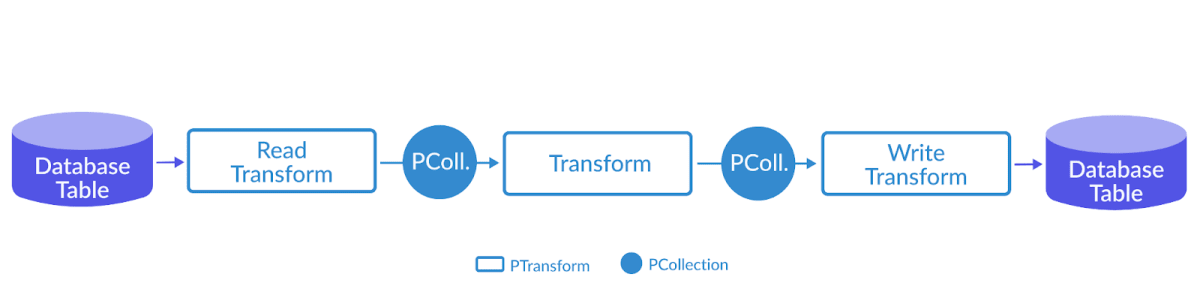
DAG Transform 是 Beam 中数据处理的最基本单元 Beam 把数据转换抽象成有向图 反直觉 - PCollection 是有向图中的边,而 Transform 是有向图中的节点 区分节点和边的关键是看一个 Transform 是不是有一个多余的输入和输出 每个 Transform 都可能有大于一个的输入 PCollection,也可能输出大于一个的输出 PCollection Apply Beam 中的 PCollection 有一个抽象的成员函数 Apply,使用任何一个 Transform 时,都需要调用 Apply 123final_collection = input_collection.apply(Transform1).apply(Transform2).apply(Transform3) Transform概述 ParDo - Parallel Do - 表达的是很通用的并行处理数据操作 GroupByKey - 把一个 Key/Value 的数据集按照 Key 归并 可以用 ParDo 实现 GroupByKey 简单实现 - 放...
2024-09-12
Big Data - Workflow
Workflow 将多种不同的处理模块连接在一起,最后得出一个 DAG,称为一个 Workflow System 在 Workflow System 中,有对应的设计模式 Copier Pattern 将单个数据处理模块中的数据,完整地复制到两个或更多的数据处理模块中,然后再由不同的数据处理模块进行处理 适用场景 - 需要对同一个数据集采取多种不同的数据处理转换 - 多个数据处理模块可以并行处理 Filter Pattern 过滤掉不符合特定条件的数据 在数据集通过 Filter 后,数据集会缩减到只剩下符合条件的数据 适用场景 - 需要针对一个数据集中某些特定的数据采取数据处理 Splitter Pattern 将数据集中的数据分类为不同的类别来进行分别处理 分离模式不会过滤任何数据,只是将原来的数据集分组 同样的数据,可以被划分到不同的数据处理模块 Joiner Pattern 将多个不同的数据集转换集中在一起,成为一个总数据集 然后将总数据集放在一个工作流中进行处理
2024-10-05
Beam - Future
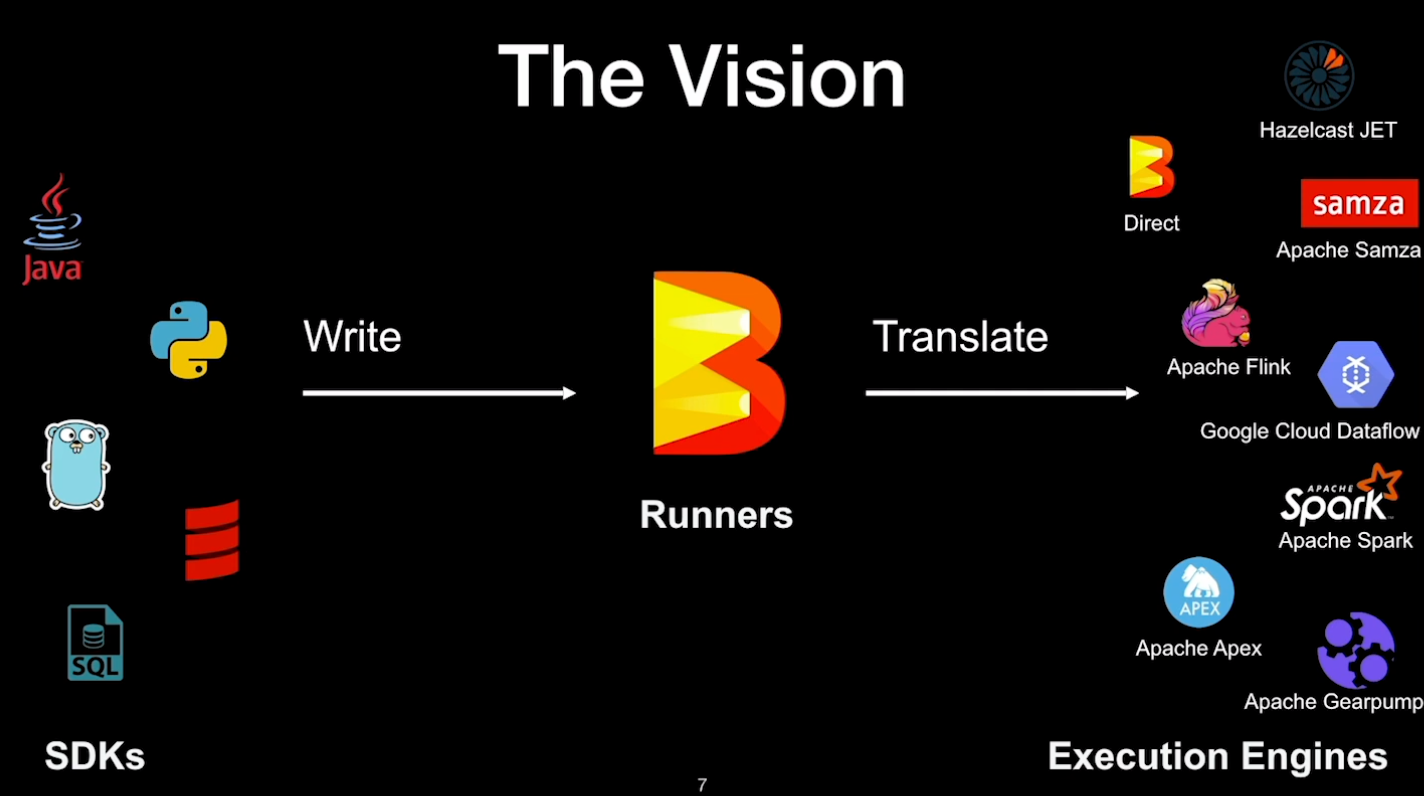
技术迭代 2006,Apache Hadoop 发布,基于 MapReduce 计算模型 2009,Spark 计算框架在 加州伯克利大学诞生,于 2010 年开源,于 2014 年成为 Apache 的顶级项目 Spark 的数据处理效率远在 Hadoop 之上 2014,Flink 面世,流批一体,于 2018 年被阿里收购 Apache Beam Apache Beam 根据 Dataflow Model API 实现的,能完全胜任批流一体的任务 Apache Beam 有中间的抽象转换层,工程师无需学习新 Runner 的 API 的语法,减少学习新技术的时间成本 Runner 可以专心优化效率和迭代功能,而不必担心迁移 Beam Runner 迭代非常快 - 如 Flink
2024-10-03
Beam - Window
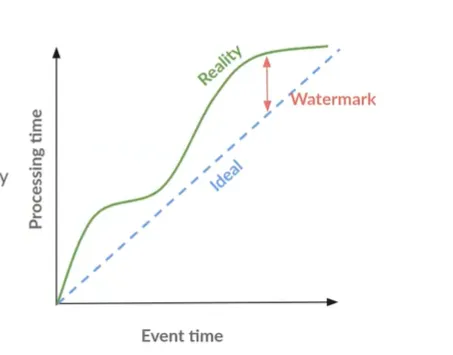
Window 在 Beam 中,Window 将 PCollection 里的每个元素根据时间戳划分成不同的有限数据集合 要将一些聚合操作应用在 PCollection 上时,或者对不同的 PCollection 进行 Join 操作 Beam 将这些操作应用在这些被 Window 划分好的不同的数据集上 无论是有界数据还是无界数据,Beam 都会按同样的规则进行处理 在用 IO Connector 读取有界数据集的过程中,Read Transform 会默认为每个元素分配一个相同的时间戳 一般情况下,该时间戳为运行 Pipeline 的时间,即处理时间 - Processing Time Beam 会为该 Pipeline 默认分配一个全局窗口 - Global Window - 从无限小到无限大的时间窗口 Global Window 可以显式将一个全局窗口赋予一个有界数据集 12PCollection<String> input = p.apply(TextIO.read().from(filepath));PCollection<String> batchI...
2024-09-10
Big Data - Distributed System
SLA Service-Level Agreement - 系统服务提供者对客户的一个服务承诺 Availabilty 可用性指的是系统服务能正常运行所占的时间百分比 对许多系统来说,99.99% 可以被认为高可用性 - 中断时间≈ 50 分钟/年 Accuracy 是否允许某些数据不准确或者丢失,如果允许发生,用户可以接受的概率 不同系统平台会用不同的指标去定义准确性,常用的是 Error Rate $$错误率=\frac{导致系统产生内部错误的有效请求数}{期间的有效请求总数}$$ Case 以分钟为单位,每个月的 Error Rate 超过 5% 的时间少于 0.1% 以 5 分钟为单位,Error Rate 不会超过 0.1% 评估系统准确性 性能测试 查看系统日志 Capacity 系统容量通常指的是系统能够支持的预期负载量是多少,一般会以每秒的请求数为单位来表示 QPS - Queries Per Second RPS - Requests Per Second 定义 Capacity 的方式 - Throttling / Perf...
2024-09-23
Beam - Context
MapReduce架构思想 提供一套简洁的 API 来表达工程师数据处理的逻辑 在这套 API 底层嵌套一套扩展性很强的容错系统 计算模型 Map 计算模型从输入源中读取数据集合 这些数据经过用户所写的逻辑后生成一个临时的键值对数据集 MapReduce 计算模型会将拥有相同键的数据集集中起来发送到下一阶段,即 Shuffle 阶段 Reduce 接收从 Shuffle 阶段发送过来的数据集 在经过用户所写的逻辑后生成零个或多个结果 划时代意义 Map 和 Reduce 这两种抽象,其实可以适用于非常多的应用场景 MapReduce 的容错系统,可以让数据处理逻辑在分布式环境下有很好的扩展性(Scalability) 不足 使用 MapReduce 来解决一个工程问题,往往会涉及非常多的步骤 每次使用 MapReduce 时,都需要在分布式环境中启动机器来完成 Map 和 Reduce 步骤 并且需要启动 Master 机器来协调两个步骤的中间结果,存在不少的硬件资源开销 FlumeJava 将所有的数据都抽象成名为 PCollection 的数据结构 无论是从内存中读取的数据,...